
AIエージェントメモリ:アーキテクチャと実装
Table of Contents
An AIエージェントが単一のインタラクションを超えて継続するタスクを処理するには、言語モデル以上のものが必要です。関連する情報を保持し、以前のインタラクションを認識し、過去の経験を活用してより適切な判断を行う必要があります。ここでAIエージェントメモリが重要になります。メモリによって、エージェントは有用なコンテキストを保持し、必要なときに情報を取得し、インタラクション間の継続性を維持できます。
しかし、メモリの実装には、会話履歴を保存したり、ベクトルデータベースに接続したりする以上のことが必要です。どの情報を保持するか、どのように整理するか、いつ取得するか、古くなった情報をどのように更新または削除するかについて判断する必要があります。
Table of Contents
主なポイント
- AIエージェントメモリにより、エージェントはインタラクション間で有用な情報を保持および取得できます。
- 短期記憶と長期記憶は情報がどのくらいの期間利用可能であるかを示し、意味記憶、エピソード記憶、手続き記憶は異なる種類の情報を示します。
- メモリアーキテクチャには通常、情報の抽出、検証、保存、取得、コンテキストの構築、メモリのメンテナンスが含まれます。
- ベクトルデータベースはセマンティック検索をサポートできますが、完全なメモリアーキテクチャではありません。
- 効果的なメモリ実装には、明確な保持ルール、アクセス制御、検索戦略、継続的な評価が必要です。
- プライバシー、古くなった情報、検索エラー、ユーザー間のデータ漏洩は、対処すべき重要なリスクです。
AIエージェントメモリとは?
AIエージェントメモリとは、AIエージェントが過去のインタラクションや経験から情報を保持、整理、取得できるようにする仕組みです。すべてのリクエストを独立したタスクとして扱うのではなく、エージェントは保存された関連情報を使用してコンテキストを理解し、より一貫した応答を行うことができます。
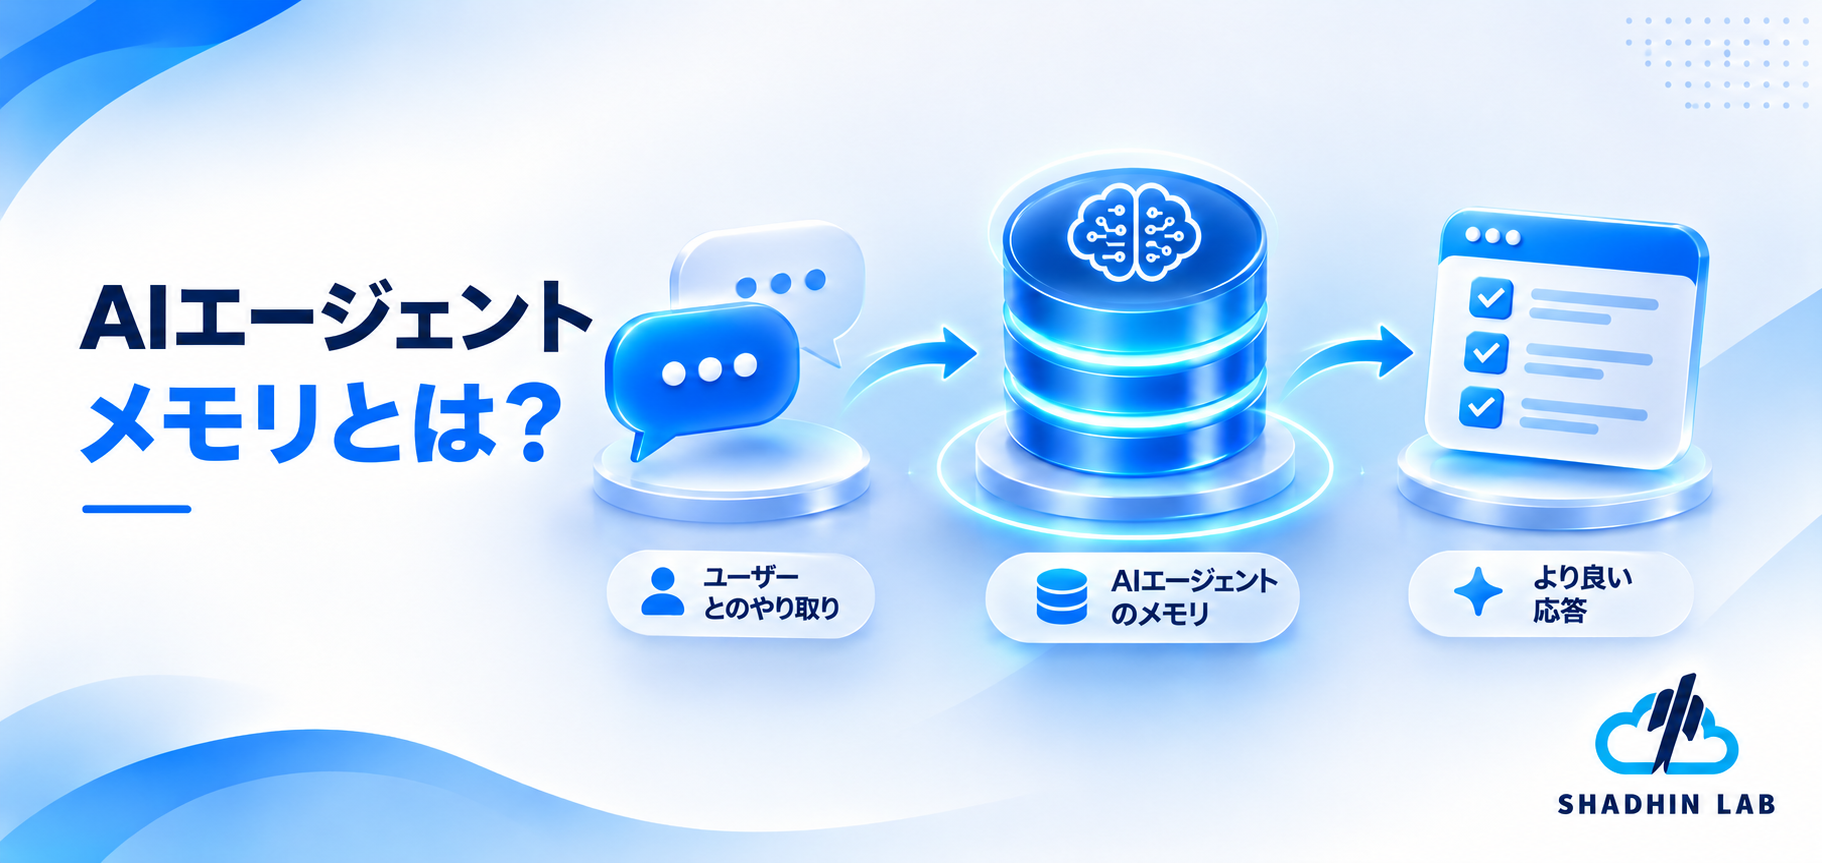
たとえば、毎週ユーザーのレポート作成を支援するビジネスアシスタントを考えてみましょう。以前のインタラクションで、ユーザーはレポートを特定の形式に従わせ、収益、顧客獲得、顧客維持の指標を優先するよう説明したとします。メモリがなければ、アシスタントは毎回これらの指示を繰り返してもらう必要があるかもしれません。適切なメモリシステムがあれば、関連する設定を保持し、それを今後のレポート作成タスクに適用できます。
メモリは、エージェントが進行中のタスクを追跡し、以前の決定を記憶し、変更された情報を認識することにも役立ちます。これは、カスタマーサービス、業務運営、リサーチ、複数ステップのワークフローをサポートするエージェントにとって特に有用です。
しかし、AIエージェントメモリは、すべての会話を無期限に保持することを意味するものではありません。有用なメモリシステムは、将来的な価値に基づいて情報を選択し、適切な形式で保存し、現在のタスクに関連する場合に取得します。
AIエージェントメモリ vs. コンテキストウィンドウ、会話履歴、RAG
これらの概念は関連していますが、それぞれ異なる目的を持っています。
| 概念 | 主な目的 | 仕組み |
| コンテキストウィンドウ | インタラクション中にモデルが利用できる情報を保持する | モデルがその時点で処理できるテキストやその他のコンテキストを提供します |
| 会話履歴 | 過去のメッセージを保持する | 以前のやり取りを記録し、それを後のインタラクションに含めることができます |
| RAG | 外部または保存された知識を取得する | 関連情報を検索し、それをモデルに提供します |
| AIエージェントメモリ | インタラクションや経験から有用な情報を保持する | 将来のエージェントの動作に向けて情報を選択、整理、更新、取得します |
コンテキストウィンドウは、モデルが直接使用する作業領域です。容量には上限があるため、エージェントは過去のすべてのインタラクションをアクティブなコンテキストに保持することに依存できません。
会話履歴は以前のやり取りの記録を提供しますが、完全なトランスクリプトが必ずしも効果的なメモリになるとは限りません。一時的な指示、関連性のない詳細、重複した情報、または古くなった事実が含まれている可能性があります。
Retrieval-Augmented Generation(RAG)は、モデルが外部ソースから関連情報にアクセスするのを支援します。ドキュメント、製品情報、社内知識、その他の参考資料を取得できます。エージェントメモリでも同様の検索技術を使用できますが、その目的は異なる場合があります。それは、ユーザー、タスク、決定、過去の経験に関する情報を保持することです。
実際には、これらのコンポーネントを組み合わせて使用できます。エージェントは、最近のコンテキストには会話履歴を、外部知識にはRAGを、今後のインタラクションに影響を与えるべき情報には永続メモリを使用できます。
AIエージェントにおけるメモリの種類
AIエージェントメモリは、情報がどのくらいの期間保持されるか、また保存される情報の種類によって分類できます。これらの分類は、完全に独立した5つのストレージシステムを表すものではなく、相互に重複するものです。

それぞれの違いを理解することで、開発者はエージェントが何を記憶すべきか、またその情報をどのように管理すべきかを判断しやすくなります。
1. 短期記憶(Short-Term Memory)
短期記憶は、現在のインタラクションやタスク中にエージェントが必要とする情報を保存します。ユーザーがすべてのメッセージで情報を繰り返す必要がなく、エージェントがコンテキストを維持できるようにします。
たとえば、エージェントが誰かの出張計画を支援する場合、目的地、旅行日程、予算、宿泊施設の希望などを一時的に保持することがあります。これらの詳細情報は、現在のタスクを完了するのに役立ちます。
短期記憶は一般的に、アクティブなセッション、会話、またはタスクに関連付けられています。アーキテクチャによっては、会話の状態、アプリケーションメモリ、またはその他の一時的なストレージメカニズムに保存される場合があります。
重要な考慮事項は、その適用範囲です。1つのタスクに必要な情報が、自動的に永続的なユーザーメモリになるべきではありません。
2. 長期記憶(Long-Term Memory)
長期記憶は、現在のインタラクションを超えて有用な情報を保持します。これにより、エージェントはセッション間の継続性を維持し、過去の経験から関連する知識を活用できます。
たとえば、カスタマーサポートエージェントは、顧客の希望するコミュニケーションチャネルや未解決の問題を記憶する場合があります。ビジネスオペレーションエージェントは、繰り返し使用されるワークフローの設定や、以前に承認された決定を保持する場合があります。
長期記憶には、一時的なコンテキストよりも慎重な管理が必要です。保存された情報は古くなったり、新しい情報と矛盾したり、関連性を失ったりする可能性があります。そのため、開発者は永続的なレコードを更新、検証、削除するためのポリシーを策定する必要があります。
3. 意味記憶(Semantic Memory)
意味記憶は、事実や概念に関する情報を保存します。これは、エージェントがさまざまなタスクで使用する必要がある知識を表します。
たとえば、ビジネスアシスタントは、組織の製品、社内用語、サービス方針、または事業構造に関する事実を保持する場合があります。特定のユーザーをサポートするエージェントは、確認済みの好みや繰り返し発生する要件を保持する場合があります。
意味記憶は、情報がどのような経緯で学習されたかという正確な出来事の順序ではなく、何が知られているかに焦点を当てます。
4. エピソード記憶(Episodic Memory)
エピソード記憶は、特定の出来事、インタラクション、または経験に関する情報を保存します。これにより、エージェントは以前に何が起こったかを参照し、過去の決定の背景を理解できます。
たとえば、プロジェクト管理エージェントは、以前の会議でプロジェクトの締め切りが変更されたこと、その変更理由、およびその後に行われた決定を保持する場合があります。
このタイプのメモリは、エージェントがタスクの履歴を理解したり、以前のアクションを説明したり、過去のインタラクションに基づいて作業を継続したりする必要がある場合に役立ちます。
5. 手続き記憶(Procedural Memory)
手続き記憶は、タスクの実行方法に関する情報を保存します。これには、ワークフロー、指示、業務手順、繰り返し発生する活動を完了するために学習したパターンなどが含まれます。
たとえば、レポート作成エージェントは、週次パフォーマンスレポートを作成するために必要な一連の手順を保持する場合があります。カスタマーサービスエージェントは、特定のカテゴリーのサポートリクエストを処理するために、承認された手順に従う場合があります。
手続き記憶は、反復可能なビジネスプロセスを実行するエージェントにとって特に有用です。ただし、組織のルールやワークフローが変更された場合は、手順を確認して更新する必要があります。
さまざまなメモリタイプの比較
| メモリの種類 | 保存する情報 | 具体例 |
| 短期記憶 | アクティブなタスクまたはセッション中に必要な情報 | 現在のプロジェクト要件 |
| 長期記憶 | インタラクションを超えて保持される情報 | ユーザーの継続的な好み |
| 意味記憶 | 事実および概念的な知識 | 会社の方針や製品情報 |
| エピソード記憶 | 特定の出来事や過去の経験 | 過去のプロジェクトに関する決定 |
| 手続き記憶 | 指示およびタスクの手順 | レポートを作成するための手順 |
短期記憶と長期記憶は、情報の保持期間または適用範囲を表します。一方、意味記憶、エピソード記憶、手続き記憶は情報のカテゴリーを表します。そのため、システムには長期的な意味記憶、長期的なエピソード記憶、または一時的な手続きコンテキストが含まれる場合があります。これらのカテゴリーを相互に排他的なストレージレイヤーとして扱うと、不必要なアーキテクチャの複雑化につながる可能性があります。
AIエージェントメモリアーキテクチャ:その仕組み
効果的なAIエージェントメモリアーキテクチャは、情報のライフサイクル全体を通じて情報を管理する必要があります。何を記憶するかを判断し、情報を有用な形式で表現し、安全に保存し、関連するレコードを取得し、状況の変化に応じてそれらのレコードを維持する必要があります。

一般的なアーキテクチャは、次のプロセスに従います。
入力 → 抽出 → 検証 → 表現 → 保存 → 取得 → コンテキスト構築 → エージェントのアクション → フィードバックと更新
重複排除、競合解決、統合、削除などのメモリメンテナンスは、このライフサイクル全体に適用されます。
1. 情報の入力
このプロセスは、エージェントがユーザー、外部システム、または自身のタスク実行から情報を受け取るときに始まります。
入力には、次のようなものが含まれます。
- ユーザーメッセージと設定
- ビジネス文書とレコード
- タスク要件と指示
- 過去の決定とインタラクションの結果
- 接続されたツールやアプリケーションから返される情報
すべての入力をメモリにするべきではありません。一時的な質問、1回限りの計算、または関連性のない詳細情報は、将来的な価値がほとんどない場合があります。
アーキテクチャでは、現在のタスクに必要な情報と、今後のインタラクションを改善する可能性のある情報を区別する必要があります。
2. 情報の抽出
エージェントまたは関連する処理コンポーネントは、受信データから潜在的に有用な情報を特定します。
たとえば、ユーザーが次のように述べたとします。
「週次レポートには、収益、リード獲得、コンバージョンのパフォーマンスを含めることを希望します。」
システムは、これを通常の会話文として扱うのではなく、継続的なレポート作成の設定として特定できます。
抽出には、エンティティ、好み、決定、タスクの結果、日付、関係性の特定などが含まれる場合があります。その目的は、非構造化されたインタラクションデータを、評価および保存できる情報に変換することです。
3. 検証とフィルタリング
情報を永続メモリにする前に、システムはその情報を保持することが適切かどうかを判断する必要があります。
この段階では、次の項目を考慮できます。
- 今後のインタラクションとの関連性
- 情報が明示されたものか、推測されたものか
- 抽出された情報の信頼度
- 既存のレコードと重複しているかどうか
- 以前に保存された情報と矛盾しているかどうか
- プライバシーおよび保持ポリシーに基づいて保存が許可されているかどうか
たとえば、ユーザーが以前の設定とは異なる新しいレポート作成の希望を提示した場合、システムは両方を同じように現在有効な情報として無条件に保存すべきではありません。新しい指示を認識し、古いレコードを処理するためのルールが必要です。
検証は、誤った推測を減らすことにも役立ちます。エージェントは、すべての発言をユーザーや組織に関する永続的な事実として自動的に扱うべきではありません。
4. メモリの表現
情報が検証を通過したら、将来の取得や利用をサポートする形式で表現する必要があります。
メモリレコードには、情報そのものに加えて、次のような補足メタデータを含めることができます。
- メモリの内容
- メモリのカテゴリー
- ユーザー、セッション、または組織の適用範囲
- 作成日時および更新日時
- 情報源または取得元
- 信頼度または検証ステータス
- 有効期限または保持に関する情報
たとえば、継続的な設定は、その設定内容、所有者、最後に確認された日時を特定する構造化レコードとして表現できます。
構造化された表現により、メモリのフィルタリング、更新、管理が容易になります。また、一時的な観察事項を永続的な指示としてエージェントが扱うことを防ぐのにも役立ちます。
5. メモリの保存
システムは、検証済みの情報を適切なストレージレイヤーに保存します。選択は、情報の種類、アクセスパターン、取得要件、アプリケーションの規模によって異なります。
一般的なストレージの選択肢には、次のようなものがあります。
| ストレージの種類 | 適した用途 | 考慮事項 |
| リレーショナルデータベース | 構造化された事実、設定、関係性、メタデータ | 構造化クエリと一貫性をサポート |
| ドキュメントデータベース | 柔軟なメモリレコードや半構造化情報 | メモリ構造が変化する場合に有用 |
| ベクトルデータベース | 埋め込み情報のセマンティック類似検索 | 適切なメタデータと検索制御が必要 |
| グラフデータベース | 接続されたエンティティ、関係性、依存関係 | 関係性が検索の中心となる場合に有用 |
| オブジェクトまたはファイルストレージ | ドキュメント、トランスクリプト、大容量ファイル | 多くの場合、インデックスまたは検索レイヤーが必要 |
システムでは、複数のストレージ技術を組み合わせることができます。たとえば、構造化されたユーザー設定をリレーショナルデータベースに保存し、選択したメモリの説明をベクトルとして保存してセマンティック検索を行うことができます。
ベクトルデータベースだけでは、完全なメモリシステムにはなりません。何を記憶すべきかを自動的に判断したり、矛盾する事実を解決したり、ユーザー権限を適用したり、情報の保持を管理したりすることはありません。
6. メモリの取得
エージェントが新しいリクエストを受け取ると、保存されている情報の中から関連するものを特定する必要があります。
検索には、複数の方法を使用できます。
セマンティック検索: 正確な表現だけでなく、意味に基づいて情報を検索します。現在のリクエストで異なる言葉が使われていても、関連する好みや経験を見つけるのに役立ちます。
キーワードまたは完全一致検索: 特定の用語、識別子、または値を含むレコードを検索します。正確な情報が必要な場合に役立ちます。
メタデータフィルタリング: ユーザー、組織、メモリの種類、日付、タスクなどの属性に基づいて、情報の取得範囲を絞り込みます。
ランキング: 関連性やその他の基準に基づいて取得したレコードを並べ替え、最も有用な情報を優先的に表示します。
たとえば、ユーザーがエージェントに別の週次レポートの作成を依頼した場合、システムはレポート作成の設定、最新のレポート期間、関連する過去の決定などを取得する可能性があります。意味的に類似しているというだけの理由で、無関係な個人情報やプロジェクト情報を取得すべきではありません。
セマンティックな類似性だけでは十分ではありません。検索では、適用範囲、鮮度、権限、現在のタスクの実際の要件も考慮する必要があります。
7. コンテキストの構築とエージェントのアクション
取得されたメモリは、見つかっただけで自動的に有用になるわけではありません。システムは、それらを選択して整理し、エージェントが利用できるコンテキストにする必要があります。
この段階では、次の要素を組み合わせることがあります。
- 現在のユーザーリクエスト
- 最近の会話コンテキスト
- 関連する短期記憶
- 選択された長期記憶
- RAGまたは接続されたツールを通じて取得された外部情報
その後、エージェントは構築されたコンテキストを使用して、何を行うかを判断したり、応答を生成したりします。
たとえば、ビジネスアシスタントがレポートを作成する場合、現在のレポート期間、ユーザーが保存したフォーマット設定、関連するビジネスデータを組み合わせることができます。これにより、過去の会話履歴全体をモデルのコンテキストに挿入することなく、継続性を提供できます。
8. フィードバックとメモリの更新
エージェントがアクションを実行した後も、メモリ管理は継続します。
新しいインタラクションによって、既存の情報が確認されたり、更新された設定が導入されたり、以前のメモリがもはや正確ではないことが明らかになったりする場合があります。
システムは、次のことをサポートする必要があります。
- 既存のレコードの更新
- 重複情報の削除
- 矛盾するメモリの解決
- 関連する経験の統合
- 一時的な情報の期限切れ
- 必要に応じた情報の削除
このメンテナンスプロセスは、長期間稼働するエージェントにとって不可欠です。これがなければ、古い情報が蓄積されるにつれて、永続メモリの信頼性が徐々に低下する可能性があります。
AIエージェントにおけるメモリの実装方法
メモリの実装には、データベースや埋め込みモデルを選択するだけでは不十分です。開発者は、メモリの目的を定義し、そのスコープを決定し、ストレージと検索のプロセスを設計し、システムが正しく動作するかどうかを評価する必要があります。

以下のステップでは、実践的な実装アプローチを説明します。
ステップ1:エージェントが記憶すべき内容を定義する
まず、将来のエージェントの動作を改善できる情報を特定します。
エージェントごとに必要なメモリは異なります。カスタマーサポートエージェントでは、顧客の好みや未解決の問題が必要になる場合があります。リサーチエージェントでは、過去の調査結果や調査上の意思決定が必要になる場合があります。ビジネスワークフローエージェントでは、繰り返し行う指示やタスクの結果が必要になる場合があります。
ストレージ技術を選択する前に、明確なメモリカテゴリを定義します。
また、エージェントが記憶すべきではない情報を特定することも重要です。一時的な情報、不要な個人情報、検証されていない推測、正当な目的のない機密情報などは、自動的に永続的なメモリに保存されるべきではありません。
明確な保持ポリシーを設けることで、メモリシステムが無関係な会話の断片の集合体になることを防げます。
ステップ2:メモリのスコープを定義する
メモリのスコープによって、特定のレコードに誰が、または何がアクセスできるかが決まります。
一般的なスコープには、以下があります。
| 範囲 | 内容 | 具体例 |
| セッションまたはスレッド | 特定のインタラクション中に利用可能 | 現在のカスタマーサポート会話の詳細 |
| ユーザー | 特定のユーザーのためにセッションをまたいで保持 | ユーザーが希望するレポート形式 |
| エージェント | 特定のエージェントが使用する共有知識 | 繰り返し行うタスクを完了するための指示 |
| 組織 | 認可されたビジネス環境内で利用可能な情報 | 承認済みの社内手順 |
スコープは重要なアーキテクチャ上の意思決定です。情報は意図された対象者の範囲を超えて共有されるべきではないためです。
たとえば、ある顧客のために保存された設定が別の顧客から利用可能になってはいけません。同様に、複数の組織にまたがって動作するエージェントは、各組織のレコードを分離して保持する必要があります。
ステップ3:ストレージと検索のアプローチを選択する
次の決定事項は、メモリをどのように保存し、検索するかです。
構造化データベースは、ユーザー設定、アカウント設定、確認済みの事実などの情報に適している場合があります。ベクトルデータベースは、意味的に関連する経験や非構造化されたメモリの説明を検索するのに役立つ場合があります。グラフデータベースは、人、プロジェクト、意思決定、エンティティ間の関係が重要な場合に有用です。
適切な選択はユースケースによって異なります。シンプルなアシスタントには、複数のデータベースや複雑な検索パイプラインは必要ない場合があります。一方、マルチエージェントのビジネスシステムでは、異なるアクセスルールと検索ルールを持つ複数のストレージレイヤーが必要になる場合があります。
開発者は、明確な要件なしにインフラストラクチャを追加することを避けるべきです。アーキテクチャはメモリの問題を解決するものであり、不必要な運用上の複雑さを生み出すものであってはなりません。
ステップ4:メモリ書き込みプロセスを設計する
書き込みプロセスによって、新しい情報がどのように永続メモリに入るかが決まります。
実用的なプロセスでは、ユーザーから明示された指示、抽出された好み、確認済みの事実、タスクの結果から推測された情報を区別する必要があります。
たとえば、エージェントが希望するレポート形式を記憶するよう直接指示を受けた場合、それはユーザーが一度同じ形式を要求したという事実から好みを推測することとは異なります。
また、システムは既存のレコードをどのように処理するかを定義する必要があります。新しい情報によって以前の設定が更新された場合、複数の矛盾するレコードを作成するのではなく、関連するメモリを変更または置き換える必要があります。
メモリへの書き込みは、アプリケーションの要件に応じて即時に行うことも、非同期プロセスを通じて行うこともできます。次回のインタラクションですぐに利用できる必要がある明示的な設定には、即時書き込みが適している場合があります。長時間のインタラクションから情報を抽出して統合する場合には、非同期処理が有用です。
どのアプローチを採用する場合でも、書き込みプロセスには、検証、重複排除、情報源の追跡、適切なアクセス制御を含める必要があります。
ステップ5:コンテキストを考慮した検索プロセスを構築する
検索プロセスによって、特定のタスクに対してどのメモリをエージェントに提供するかが決まります。
まず、それぞれのタスクに必要な情報の種類を特定します。カスタマーサポートのリクエストでは、アカウント設定や最近のサポート履歴が必要になる場合があります。レポート作成タスクでは、保存された書式設定や過去のレポートに関する意思決定が必要になる場合があります。
検索では、情報をエージェントに提示する前に、スコープと権限のフィルターを適用する必要があります。また、情報の鮮度と関連性も考慮する必要があります。
開発者は、すべてのリクエストに対して利用可能なすべてのメモリを取得することを避けるべきです。過剰なコンテキストは処理コストを増加させ、関連性のない情報を導入し、エージェントの一貫性を低下させる可能性があります。
有用な検索システムは、その意味と情報源を理解するのに十分なコンテキストを備えた、関連性の高い限定されたレコードを返します。
ステップ6:メモリを評価・維持する
メモリの実装は、システムが情報を正常に保存・検索できるようになった時点で完了するわけではありません。時間の経過とともに評価する必要があります。
有用な評価項目には、以下があります。
保持精度: エージェントは、記憶すべき情報を保持しながら、不要な詳細を保存していないか?
検索精度: 特定のリクエストに対して、適切な情報を検索できているか?
更新動作: 古くなった設定を置き換え、矛盾するレコードを解決できるか?
分離と権限: ユーザーは、自分にアクセス権限があるメモリのみを利用できるか?
レイテンシーとコスト: メモリの検索によって、許容できない遅延やインフラストラクチャコストが発生していないか?
削除と保持: 必要に応じて情報を削除し、保持ポリシーを適用できるか?
テストには、複数のセッションにまたがる現実的なインタラクションを含める必要があります。短時間のデモンストレーションではメモリシステムが正常に動作しているように見えても、情報が古くなった場合、複数のユーザーが同じ環境を共有している場合、または複数の類似したレコードが検索対象として競合する場合に、正常に動作しなくなる可能性があります。
AIエージェントのメモリシステムにおける一般的な課題
メモリはエージェントをより便利にする一方で、設計が不十分なメモリは、信頼性、プライバシー、パフォーマンスに関する問題を引き起こす可能性があります。
1. 無関係または過剰なメモリ
情報を保存しすぎると、検索の効果が低下する可能性があります。エージェントが不要な詳細情報を取得したり、より多くのコンテキストを消費したり、重要な情報を特定することが難しくなったりする場合があります。
解決策は、選択的な保持です。将来的に価値のある情報を定義し、保存する前にフィルタリングを適用します。保存された記録を定期的に確認し、不要になった情報を削除します。
2. 矛盾した情報と古い情報
ユーザーの好み、ビジネスプロセス、プロジェクト要件は変化する可能性があります。古いメモリが更新されないまま有効になっていると、エージェントがすでに有効ではない指示に従ってしまう可能性があります。
メモリレコードには、タイムスタンプと情報源を含めるべきです。また、新しく確認された情報が古い記録にどのように優先するのか、未解決の矛盾をどのように処理するのかについても、システム内で定義する必要があります。
3. 検索エラー
メモリシステムは、意味的には関連していても、現在のタスクには実際には関係のない情報を取得する場合があります。また、検索方法が意味的類似性に依存しすぎると、正確な情報を見落とす可能性もあります。
セマンティック検索とキーワード検索、メタデータによるフィルタリング、ランキングを組み合わせることで、検索品質を向上させることができます。開発者は、データベース検索が成功すれば有用なコンテキストが得られると想定するのではなく、現実的なクエリを使用して検索結果を評価する必要があります。
4. プライバシーとユーザー間のデータ漏洩
永続的なメモリには、ユーザーの好み、ビジネス情報、その他の機密性の高い記録が含まれる場合があります。不適切なアクセス制御によって、あるユーザーの情報が別のユーザーや組織に公開される可能性があります。
メモリシステムには、認可チェック、テナント分離、明確なデータ所有権のルールが必要です。データは、適切なユーザーまたは組織のスコープ内でのみ取得されるべきです。また、保持および削除のポリシーは、アプリケーションのプライバシー要件やコンプライアンス要件を反映する必要があります。
5. レイテンシーとインフラストラクチャコスト
メモリに関するすべての処理は、追加の処理負荷を発生させる可能性があります。情報の抽出、埋め込みの生成、データベースクエリ、再ランキング、コンテキストの組み立てなどにより、応答時間やインフラストラクチャコストが増加する可能性があります。
すべてのインタラクションで永続的なメモリ検索が必要なわけではありません。開発者は、タスク固有の検索ルール、効率的なインデックス作成、適切なキャッシュ、選択的なメモリ更新などを活用して、不要な処理を削減できます。
目標は、最大量の情報を取得することではありません。適切なタイミングで、エージェントに適切な情報を提供することです。
信頼性の高いAIエージェントメモリを構築するためのベストプラクティス
信頼性の高いメモリシステムは、特定のデータベースやフレームワークの機能ではなく、エージェントが実際に担う役割を中心に設計する必要があります。

将来的な価値のある情報を保存する。 確認済みの好み、重要な意思決定、繰り返し使用される指示、タスクの結果を優先します。すべてのメッセージを永続的なメモリとして扱うことは避けます。
一時的なコンテキストと永続的なメモリを分離する。 現在のセッションでのみ必要な情報を、自動的に無期限で保持すべきではありません。セッションレベルの記録と長期的な記録の間に明確な境界を定義します。
精度が重要な場合は構造化された記録を使用する。 好み、日付、識別子、確認済みの事実などは、構造化されたストレージとメタデータを利用することで、より適切に管理できます。セマンティック検索は、この構造を置き換えるのではなく、補完するものとして活用できます。
ベクトル検索を選択的に使用する。 ベクトルデータベースは、意味に基づいて情報を検索する場合に有用です。ただし、特に正確な値や構造化されたフィルターが重要な場合など、すべてのメモリタイプに必要なわけではありません。
情報源とタイムスタンプを記録する。 メモリレコードには、情報がどこから取得されたのか、いつ作成または更新されたのかを示す必要があります。これにより、検証や矛盾の解決が容易になります。
検索時にアクセス制御を適用する。 メモリがモデルに渡される前に、ユーザー、エージェント、組織ごとの境界を適用します。プライベートな情報を保護するために、モデルのプロンプト内の指示だけに依存してはいけません。
メモリを維持・更新する。 重複排除、統合、期限切れ、矛盾処理、削除のためのプロセスを実装します。情報が変化しても、メモリシステムが有用であり続けるようにする必要があります。
ライフサイクル全体を評価する。 情報の抽出、保存、検索、更新、権限、削除をテストします。情報を保存できるかどうかだけを測定しても、メモリシステムが信頼性高く機能していることを証明することにはなりません。
AIエージェントのメモリに関するよくある質問
AIエージェントにおけるメモリとは何ですか?
AIエージェントにおけるメモリとは、過去のインタラクションや経験から得られた有用な情報を保持、整理、検索するためのシステムです。これにより、エージェントはコンテキストを維持し、関連するユーザーの好みを記憶し、複数回のインタラクションにわたってタスクを継続できるようになります。
AIエージェントのメモリはどのように機能しますか?
AIエージェントのメモリシステムは、役立つ可能性のある情報を特定し、検証し、適切な形式で保存し、必要に応じて関連する記録を検索します。検索された情報はエージェントの現在のコンテキストに追加され、次のアクションやレスポンスに反映されます。また、システムには古くなった情報を更新または削除する仕組みも必要です。
AIエージェントにおける短期メモリと長期メモリの違いは何ですか?
短期メモリは、現在進行中のセッションやタスクに必要な情報を保持します。長期メモリは、複数のセッションやインタラクションにわたって選択された情報を保持します。短期メモリは即時の継続性を支援し、長期メモリはエージェントが過去の経験から関連する情報を活用できるようにします。
RAGとAIエージェントのメモリの違いは何ですか?
RAGは、外部または保存されたナレッジソースから関連する情報を検索し、生成時にモデルへ提供します。一方、AIエージェントのメモリは、好み、意思決定、過去のタスク経験など、将来のエージェントの動作に影響を与える可能性のある情報を保持・管理することに重点を置いています。エージェントのメモリシステムではRAG型の検索技術を利用できますが、この2つの概念は同一ではありません。
AIエージェントのメモリにはベクトルデータベースが必要ですか?
いいえ。ベクトルデータベースは、特に非構造化情報を対象として意味的類似性検索を行う必要がある場合に有用です。ただし、その他のメモリ要件には、構造化データベース、ドキュメントストア、グラフデータベースなどの方が適している場合があります。複数のストレージ技術を組み合わせるシステムもあります。
AIエージェントはどのようにして会話をまたいで情報を記憶できますか?
エージェントは、選択した情報を外部ストレージシステムに保存し、新しい会話が始まった際に関連する記録を取得することで、永続的なメモリを維持できます。アプリケーションは、メモリを正しいユーザーまたは組織に関連付け、適切なアクセス制御を適用する必要があります。
AIエージェントのメモリは更新または削除できますか?
はい。適切に設計されたメモリシステムでは、既存の記録の更新、矛盾する情報の解決、重複の削除、必要に応じた情報の削除をサポートする必要があります。メモリ管理は、後から追加するオプション機能ではなく、アーキテクチャの一部として設計するべきです。
まとめ
AIエージェントのメモリは、個々のインタラクションを、より継続的でコンテキストを理解した体験へと変えるのに役立ちます。しかし、効果的なメモリを実現するために必要なのは、単に会話履歴を保持したり、ベクトルデータベースを接続したりすることだけではありません。
開発者は、エージェントが何を記憶すべきかを定義し、適切なメモリのスコープを設定し、適切なストレージおよび検索方法を選択し、情報が変化した際にそれを維持・管理する必要があります。プライバシー、アクセス制御、検索精度、削除ポリシーも同様に重要です。
実際のアプリケーション要件を中心にメモリを設計することで、開発チームは、不要または信頼性の低い情報を蓄積することなく、過去のインタラクションをより効果的に活用できるエージェントを構築できます。
実用的なAIシステムを検討している企業にとって、 ShadhinLabのAIソリューションとサービス は、AIを活用したアプリケーションやワークフローについて相談するための出発点となります。

Shaif Azad
Shaif Azad Rahi氏は、Shadhin Labのソリューションエンジニアとして活躍するAI・機械学習の専門家です。AIを活用したソリューションやスケーラブルなソフトウェアシステムを専門とし、実際のビジネス課題の解決にAIを応用することに注力しています。
Related Post
Zoho vs HubSpot:あなたのビジネスに最適なCRMはどちら?
Choosing a customer relationship management (CRM) platform is about more than organizing contacts. Your CRM needs...
SaaSセキュリティチェックリスト:必須の15のセキュリティ対策
A SaaS company may store customer information, process requests through shared infrastructure, and connect multiple services...
ERPとCRM:自社のビジネスに適しているのはどちら?
Imagine a growing business where sales representatives track leads in spreadsheets while the operations team manages...
