
LLM向けAIインフラストラクチャ:構成要素、コスト、導入
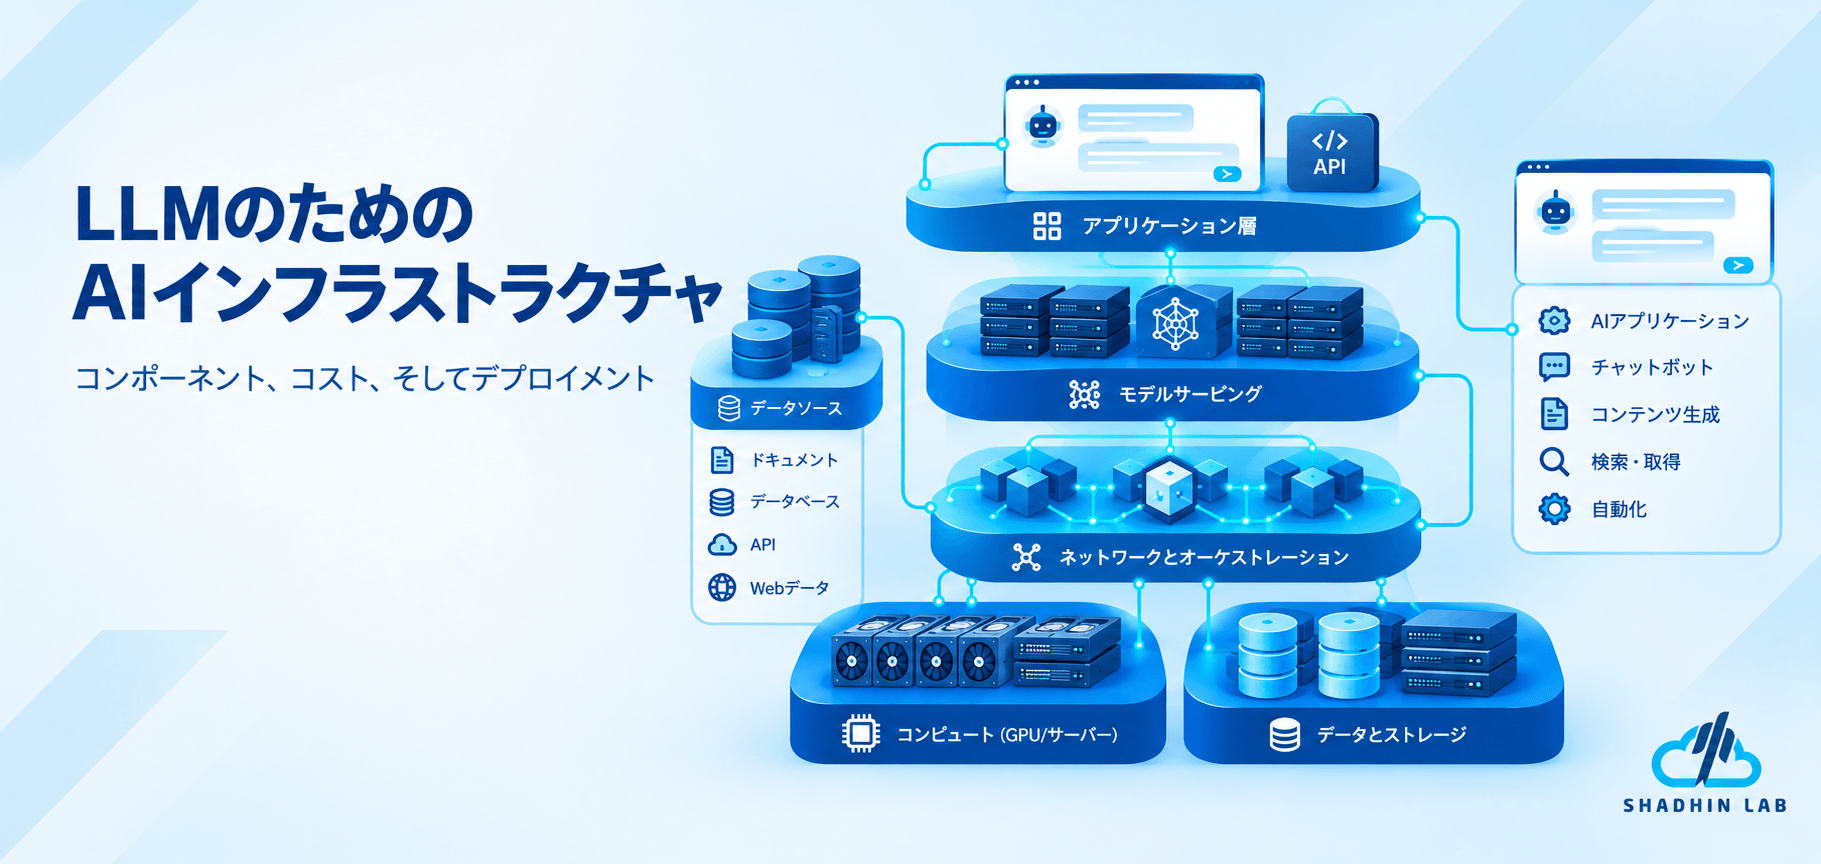
Table of Contents
大規模言語モデル(LLM)は、本番環境で安定して動作するために、単に高性能なGPUだけでは不十分です。LLMは、計算リソース、ストレージ、ネットワーク、モデル提供、データ検索、セキュリティ、監視機能などを含む、相互に接続されたインフラストラクチャスタックに依存しています。
適切な構成は、何を構築するかによって異なります。ホスト型モデルAPIを利用する社内向けナレッジアシスタントは、数千人の同時ユーザーにオープンウェイトモデルを提供する顧客向けアプリケーションとは、必要となるインフラ要件が大きく異なります。
技術責任者にとっての課題は、不要なコストや運用の複雑化を招くことなく、性能・セキュリティ・信頼性の要件を満たすアーキテクチャを選択することです。
このガイドでは、LLM向けAIインフラストラクチャの主要な構成要素を解説し、導入モデルを比較するとともに、本番システムを構築・最適化するための実践的なフレームワークを提供します。
Table of Contents
主なポイント
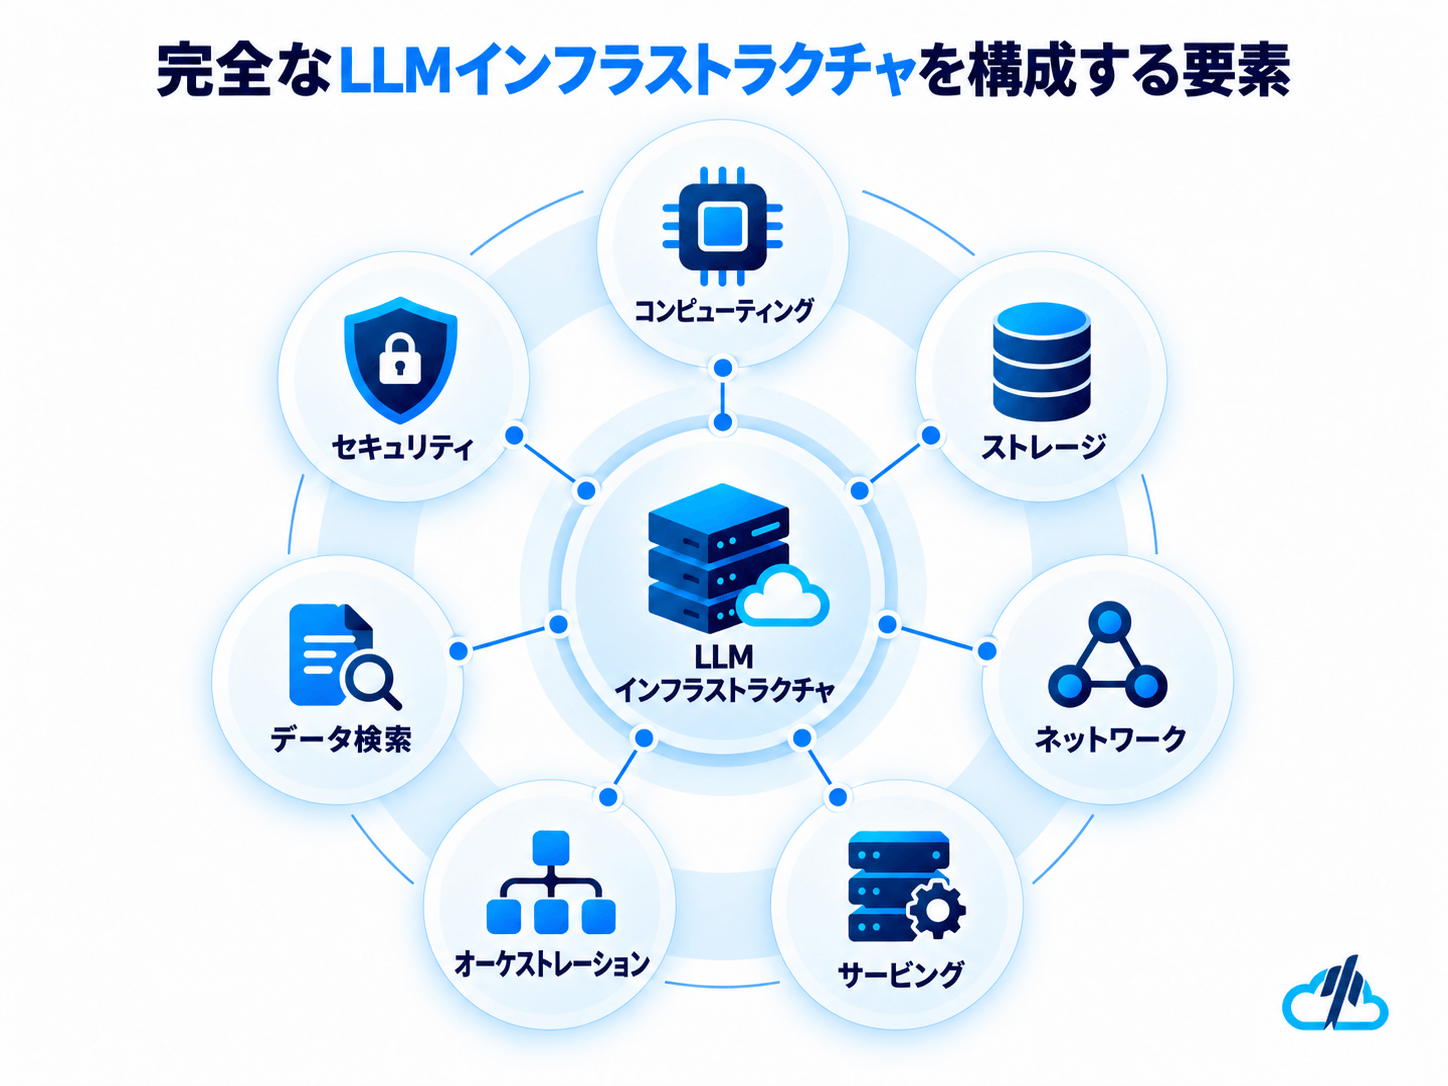
- LLMインフラストラクチャは完全なシステムです。 計算リソース、ストレージ、ネットワーク、推論、データパイプライン、セキュリティ、監視機能が連携して動作します。
- 学習(Training)と推論(Inference)では必要な要件が異なります。 学習はモデルパラメータの習得や調整に重点を置き、推論はユーザーからの要求を処理して出力を生成する役割を担います。
- すべてのアプリケーションがGPUを必要とするわけではありません。ホスト型LLM APIを利用する企業は、 多くの場合、モデル提供用のハードウェアを管理せずにアプリケーションを構築できます。
- デプロイ方法の選択にはトレードオフがあります。 ホスト型APIは運用を簡単にしますが、セルフホスティングはより大きなエンジニアリング負担と引き換えに、より高い制御性を提供します。
- ワークロードの特性が必要なインフラを決定します。 モデルサイズ、コンテキスト長、同時利用者数、レイテンシ目標、リソース使用率などがキャパシティ計画に影響します。
- まずはシンプルな構成から始め、実際のデータに基づいて最適化します。アプリケーションを検証し、 実際の性能を測定した上で、必要な場合のみ、より複雑なインフラストラクチャを導入します。
LLM向けAIインフラストラクチャとは何か?
LLM向けAIインフラストラクチャとは、大規模言語モデル(LLM)アプリケーションを開発、導入、提供、維持するために必要なハードウェア、ソフトウェア、データシステム、運用サービスを組み合わせたものです。
これには、モデルを実行するためのリソースだけでなく、実際のアプリケーションでモデルを有効活用するための周辺システムも含まれます。これらのシステムは、リクエストの認証、企業文書の検索、プロンプト管理、アクセス制御の実施、品質監視、障害対応などを行います。
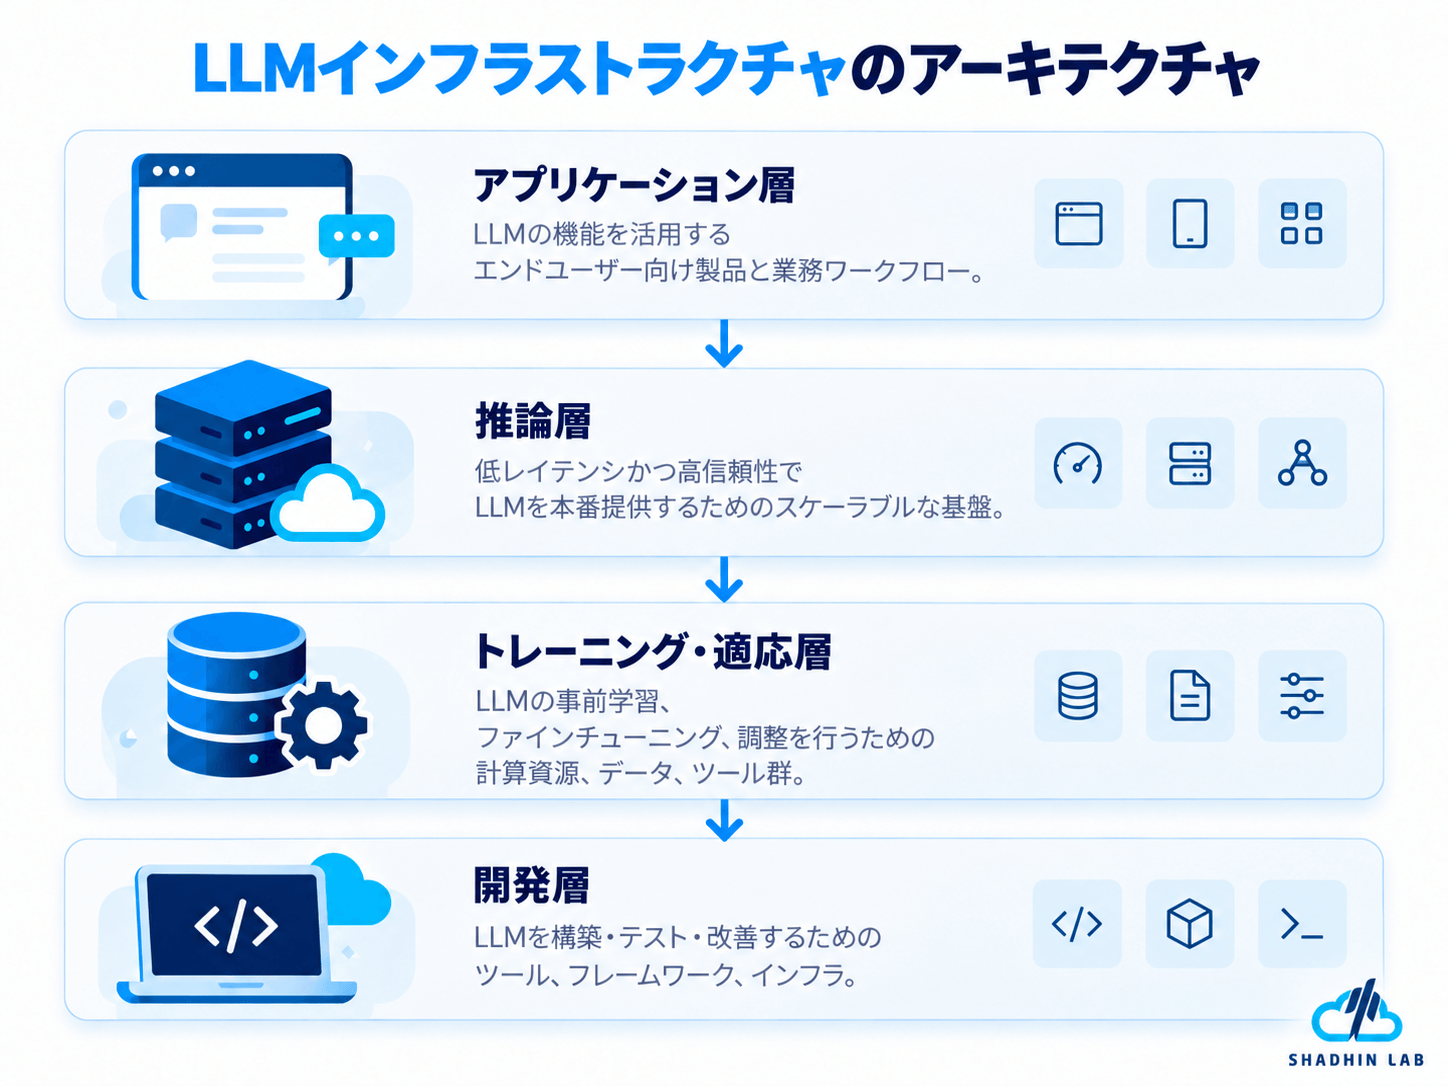
LLMインフラストラクチャは、一般的に以下の4つのカテゴリーに分類されます。
| インフラ層 | 主な目的 | 一般的な構成要素 |
|---|---|---|
| 発達 | モデルの実験や性能評価を行う | ノートブック、テスト環境、評価用データセット |
| インフラ層 主な目的 一般的な構成要素 開発(Development) | モデルの学習またはファインチューニングを行う | GPU、分散コンピューティング、データセット、チェックポイント |
| 推論(Inference) | 学習済みモデルを実行し、回答を生成する | モデル提供エンジン、AIアクセラレーター、API |
| アプリケーション(Application) | モデルをビジネスワークフローに接続する | API、検索システム、プロンプト管理、認証、監視 |
これらの層は一部重複する場合がありますが、それぞれ異なる役割を持っています。オープンウェイトモデルをファインチューニングする企業は専用の学習リソースを必要とする場合があります。一方、商用APIを利用してAIアシスタントを構築する企業では、アプリケーションインフラとモデル提供者への安定した接続だけで十分な場合があります。
LLMインフラストラクチャスタックの仕組み
企業の内部文書を利用して質問に回答するAIアシスタントを考えてみましょう。そのリクエスト処理の流れは、以下のようになります。
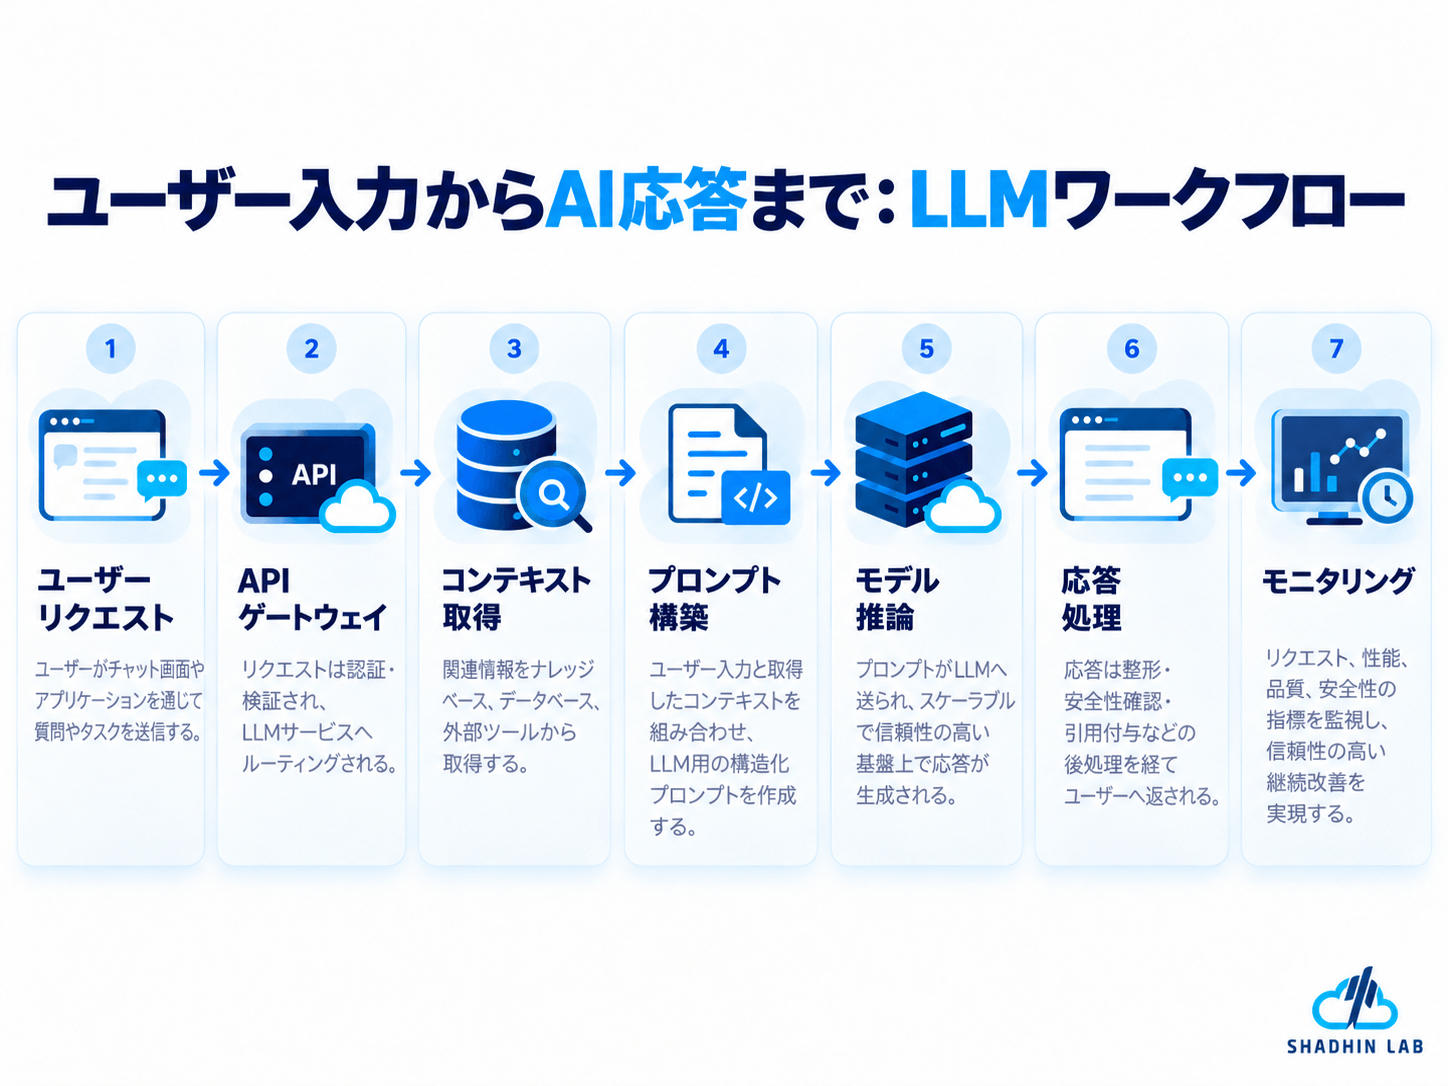
- アプリケーションリクエスト: ユーザーがWebアプリケーションや社内ツールを通じて質問を送信します。
- APIゲートウェイ: システムはリクエストの認証、権限確認、入力内容の検証、利用制限(レート制限)の適用を行います。
- コンテキスト検索: 質問に企業固有の知識が必要な場合、検索システムが許可された文書を検索し、関連する情報部分を選択します。
- プロンプト構築: アプリケーションは、ユーザーの質問、取得したコンテキスト、適用される指示を組み合わせてプロンプトを作成します。
- モデル推論: ホスト型APIまたは自社運用の推論エンジンがリクエストを処理し、回答を生成します。
- レスポンス処理: 必要に応じてアプリケーションが回答内容を検証し、ユーザーへ返します。
- 監視: システムは運用指標、エラー、トークン使用量、応答遅延(レイテンシ)、品質に関する重要な情報を記録します。
すべてのアプリケーションが、これらすべての構成要素を必要とするわけではありません。単純な文章生成機能では検索システムが不要な場合があります。一方、企業向けAIアシスタントでは、より強固な本人認証、文書アクセス権限管理、監査可能性が必要になります。
重要な点は、モデル自体は本番システムを構成する一部分にすぎないということです。
LLMインフラストラクチャが従来のアプリケーションインフラストラクチャと異なる理由
従来のWebアプリケーションは、多くの場合、事前に定義されたビジネスロジックやデータベースクエリを実行します。一方、LLMアプリケーションでは、リクエストに含まれるコンテキスト量が異なり、生成される回答の長さも予測できないため、追加の変数が発生します。
これらの違いにより、インフラストラクチャには以下のような課題が生じます。
- GPUメモリ: モデルの重み(Model Weights)や実行時の状態データを保存するため、大容量のAIアクセラレータメモリが必要になる場合があります。
- 変動するワークロード: 短い分類処理のリクエストは、長いコンテキストを含む会話処理とは異なるリソース量を消費します。
- 生成レイテンシ: ユーザーは、最初のトークンが表示されるまでの時間だけでなく、その後のトークン生成速度も重要視する場合があります。
- スループット: システムは、多数の同時リクエストを許容できない遅延を発生させずに処理する必要があります。
- モデルアーティファクト: モデルの重みやチェックポイントは大容量になる可能性があり、適切なストレージ管理とバージョン管理が必要です。
- 1リクエストあたりのコスト: 入力トークン数、出力トークン数、ハードウェア使用率、運用コストなどが全体の経済性に影響します。
そのため、インフラストラクチャの計画は、最初にハードウェア購入を考えるのではなく、アプリケーションのワークロード(利用状況・処理要件)を理解することから始めるべきです。
LLM向けAIインフラストラクチャの主要な構成要素
計算リソースは、モデルの学習や回答生成に必要な計算処理を実行します。
CPUも依然として重要です。リクエスト処理、前処理、処理の調整(オーケストレーション)、データ移動、その他GPU上で実行する必要のないアプリケーション処理を担当します。
GPUは、多数の処理を並列実行できるため、LLMワークロードで広く利用されています。また、モデルとの互換性、ソフトウェアサポート、利用可能性、性能要件によっては、その他の専用AIアクセラレーターも適しています。
CPUも依然として重要です。リクエスト処理、前処理、処理の調整(オーケストレーション)、データ移動、その他GPU上で実行する必要のないアプリケーション処理を担当します。
必要なハードウェアは、単にモデルのパラメータ数だけで決まるわけではありません。重要な要素には以下があります。
- モデルウェイト: モデルのパラメータとその数値表現方法が、必要なメモリ容量の大部分を決定します。
- 量子化(Quantization): モデルウェイトを低精度で表現することで、品質や互換性への影響を考慮しながら、必要なメモリ量を削減できます。
- コンテキスト長: 長いプロンプトや会話履歴は、実行時に必要なメモリ量を増加させます。
- 同時実行数(Concurrency): 複数の同時リクエストは、計算リソースやメモリを共有するため、負荷が増加します。
- 性能目標: 低レイテンシが求められるアプリケーションは、非同期処理やバッチ処理のワークロードよりも大きな処理能力が必要になる場合があります。
小規模なモデルは1台のGPUで動作できる場合がありますが、大規模モデルや高負荷なワークロードでは複数のGPUが必要になることがあります。一部のモデルは複数デバイスに分散できますが、その場合、通信オーバーヘッドや運用の複雑性が増加します。
実践的な推奨事項: GPUの種類や台数を決定する前に、必要なメモリ量を見積もり、実際の利用環境を想定したベンチマークテストを実施してください。特定の「モデルサイズとGPU数の関係」をすべてのケースに当てはめることは避けるべきです。
2. ストレージとモデルアーティファクト
LLMインフラストラクチャでは、モデル本体だけでなく、さまざまなデータを保存するためのストレージが必要です。アプリケーションによっては、学習データセット、評価結果、ファインチューニングのチェックポイント、埋め込みデータ(Embeddings)、検索された文書、ログ、設定ファイルなどを保存します。
ストレージ設計は、モデルの読み込み、データ準備、復旧、再現性に影響を与えます。
オブジェクトストレージは、モデルアーティファクト、データセット、保存済みの評価結果を管理するために有効です。大規模モデルを高速に読み込む必要がある場合や、学習パイプラインで大量のデータを処理する場合には、高スループットのストレージが重要になります。データベースや検索インデックスは、アプリケーションデータの保存や関連文書の検索など、それぞれ異なる目的で利用されます。
本番環境では、モデルアーティファクトのバージョン管理と、機密データへのアクセス制御も維持する必要があります。チームは、特定のデプロイ環境で使用されているモデルのバージョン、プロンプト設定、評価結果を正確に把握できる必要があります。
ストレージ性能は、実際のデータアクセスパターンに基づいて設計する必要があります。すべてのLLMアプリケーションが、高性能な分散ストレージシステムを必要とするわけではありません。
3. ネットワークと分散コンピューティング
ネットワークは、アプリケーションサービス、ストレージシステム、CPU、AIアクセラレーターを接続します。モデルを複数のGPUやマシンに分散して実行する場合、ネットワークの重要性はさらに高まります。
例えば、マルチGPU環境では、デバイス間で頻繁な通信が必要になる場合があります。AIアクセラレーター自体が高性能であっても、低速な接続はボトルネックになる可能性があります。また、ストレージと計算リソース間のデータ転送速度も、モデルの読み込みや学習処理のスループットに影響を与えます。
分散コンピューティングは、1台のデバイスの処理能力を超えるワークロードや、追加の推論処理能力が必要な場合に利用されます。テンソル並列(Tensor Parallelism)やパイプライン並列(Pipeline Parallelism)などの技術により、モデルの計算処理を複数のデバイスへ分割します。
しかし、モデルを分散配置すると、同期処理、ネットワーク通信量、障害対応、デプロイの複雑性など、新たな課題が発生します。
ホスト型モデルAPIを利用する小規模なアプリケーションでは、通常、GPU間ネットワークを管理する必要はありません。一方、自社運用型(セルフホスティング)のシステムでは、ワークロード要件が必要と判断した場合にのみ、高帯域幅の接続技術やマルチノードアーキテクチャを導入するべきです。
4. モデル提供(Model Serving)と推論エンジン(Inference Engines)
推論エンジンは、モデルの読み込み、実行管理、リクエスト処理のスケジューリング、出力トークンの生成を行います。セルフホスティング型LLM環境では、推論エンジンはモデル提供レイヤーの中心的な役割を果たします。
TensorRT-LLM vLLMやNVIDIA そして NVIDIA TensorRT-LLM などのツールは、LLMの提供や最適化に特化した機能を提供します。また、マネージド型モデル提供サービスを利用することで、基盤となるすべてのコンポーネントを自分たちで管理せずにモデルを展開することも可能です。
モデル提供ソリューションを評価する際には、以下の点を考慮する必要があります。
- スループット: 一定時間内にシステムが処理できるリクエスト数やトークン数はどの程度か。
- レイテンシ: リクエスト送信後、どれくらい早く回答生成が開始され、その後のトークンがどの速度で生成されるか
- バッチ処理: 複数のリクエストをまとめて処理し、ハードウェア利用効率を向上できるか。
- メモリ管理: モデルウェイトや生成処理中に使用されるKey-Value(KV)キャッシュをどれだけ効率的に管理できるか。
- 互換性: 選択したモデルアーキテクチャ、精度設定、ハードウェア、必要な機能をサポートしているか。
- 運用性: システムの導入、更新、デバッグ、保守がどの程度容易か。
推論スタックでは、APIフロントエンドとモデル提供バックエンドを分離する場合があります。フロントエンドはリクエスト処理、ルーティング、キュー管理、メトリクス収集を担当し、バックエンドはモデルの計算処理を実行します。
最も優れたエンジンとは、必ずしも公開ベンチマークで最高性能を示すものではありません。実際に使用するモデルとリクエストパターンを現実的な環境でテストし、運用に必要なエンジニアリング作業も考慮する必要があります。
5. オーケストレーションとスケーリング
オーケストレーションは、アプリケーションサービスやモデル提供ワークロードの展開、更新、再起動、スケール調整を管理します。
Dockerコンテナは、アプリケーションと必要な依存関係をパッケージ化します。Kubernetesは、クラスタ全体でこれらのコンテナを管理し、デプロイメントの制御、スケーリング、計画的なアップデートをサポートします。
LLMアプリケーションでは、オーケストレーションによって以下のような管理が可能になります。
- モデル提供ワーカーのデプロイと更新。
- 利用可能なインスタンス間でのリクエスト分散。
- 需要の変化に応じた処理能力のスケーリング。
- ヘルスチェックの実行と、障害が発生したワークロードの自動置換。
- 設定情報や機密情報(Secrets)の管理。
- 新しいアプリケーションバージョンやモデルバージョンの段階的な展開。
Kubernetesは複雑な本番システムでは有効ですが、すべてのLLMプロジェクトに必須というわけではありません。初期段階のアプリケーションやトラフィックが少ないシステムでは、マネージドAPI、サーバーレスサービス、またはよりシンプルなデプロイ方法の方が適している場合があります。
オーケストレーションは、大規模アーキテクチャの標準要素だから導入するのではなく、アプリケーションの運用要件に基づいて選択するべきです。
6. データと検索(Retrieval)インフラストラクチャ
多くのビジネスアプリケーションでは、LLMが学習時に含まれていない社内文書、製品情報、顧客記録、その他のデータを利用して質問に回答する必要があります。
検索拡張生成(RAG:Retrieval-Augmented Generation)は、関連情報を検索し、それをモデルのコンテキストとして提供することで、この要件に対応します。
一般的なRAGパイプラインには、以下の処理が含まれます。
- 承認された情報源から文書を取り込む。
- コンテンツを整理し、管理しやすい小さなチャンク(分割単位)に分ける。
- 埋め込み(Embedding)を生成し、コンテンツを数値ベクトルとして表現する。
- ベクトルデータベースまたはその他の検索システムにコンテンツをインデックス化する。
- ユーザーの質問に関連する情報部分を検索する。
- 許可されたコンテキスト情報をLLMへ渡し、根拠に基づいた回答を生成する。
このインフラストラクチャには、メタデータフィルター、文書アクセス権限管理、定期更新処理、削除ワークフローなども必要になる場合があります。
検索機能はアプリケーションレベルの能力であり、モデル提供インフラストラクチャの代替ではありません。ベクトルデータベースが不安定な推論システムを補うことはできません。また、高速な推論エンジンでも、検索品質が低い場合の問題を解決することはできません。
企業向けアプリケーションでは、アクセス制御はユーザーのログイン時だけでなく、情報検索の段階でも適用する必要があります。そうしなければ、LLMがユーザーに閲覧権限のない情報を受け取ってしまう可能性があります。
7. 監視、セキュリティ、信頼性
LLMアプリケーションは、技術的には稼働していても、質の低い回答を生成したり、コストが過大になったり、機密情報を漏えいしたりする可能性があります。そのため、本番環境の監視では、システム性能とアプリケーション品質の両方を対象にする必要があります。
主要な運用指標には、レイテンシ、スループット、リクエスト失敗率、可用性、入力・出力トークン使用量、コストなどがあります。品質監視では、回答精度、検索結果の関連性、指示への適合性、タスク完了度などを評価する場合があります。
セキュリティ対策には、認証、認可、機密情報(Secrets)の管理、必要に応じた暗号化、モデルエンドポイントへのアクセス制限などを含める必要があります。また、チームは機密性の高いプロンプト、検索された文書、生成された回答をどのようにログ保存・保持するかを明確に定める必要があります。
モデルとプロンプトのバージョン管理は、性能低下(リグレッション)の調査や動作の再現に役立ちます。自動評価システムはリリース前に代表的なタスクをテストでき、一方で本番環境のレビューでは、テストでは発見できない問題を特定できます。
信頼性を確保するためには、明確な障害対応も必要です。アプリケーションでは、タイムアウト、再試行(リトライ)、フォールバック動作、レート制限、エスカレーション手順を定義する必要があります。繰り返しのリトライによって、一時的なサービス提供者側の問題が、より大きなコスト増加や可用性障害につながらないようにする必要があります。
適切なLLMインフラストラクチャ導入モデルの選択
適切な導入モデルは、制御範囲、エンジニアリング能力、プライバシー要件、トラフィックパターン、総所有コスト(TCO)によって決まります。
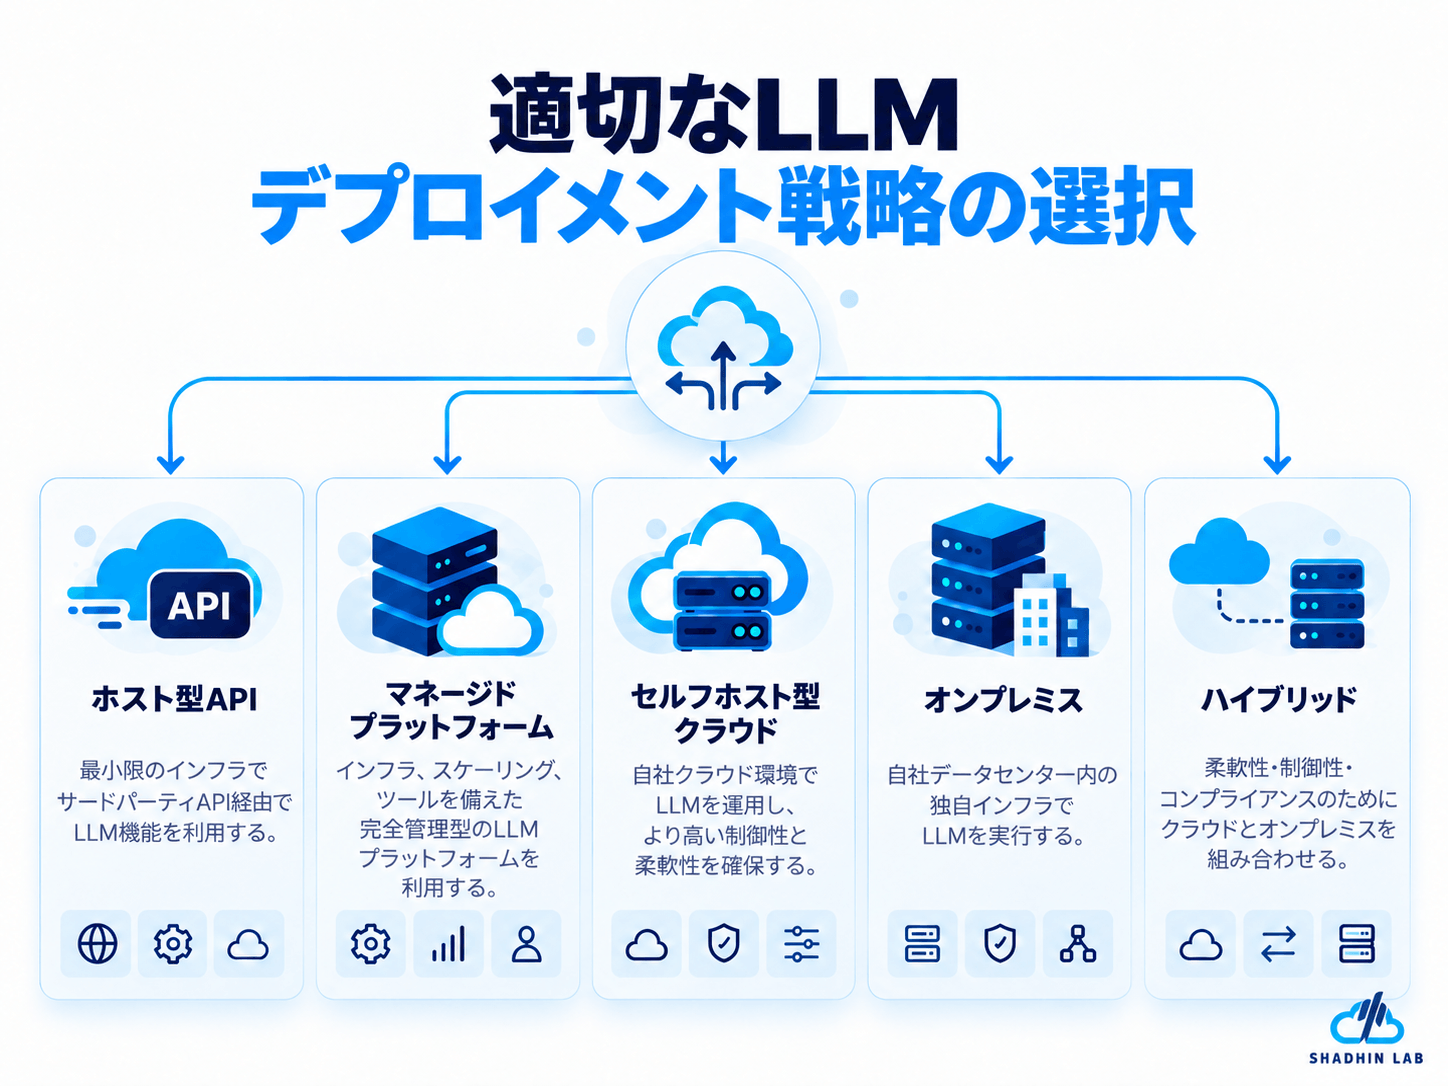
| 導入モデル(Deployment model) | 適している用途(Best suited for) | 主なトレードオフ(Main trade-off) |
|---|---|---|
| ホスト型LLM API | 迅速な開発や変動するワークロード | 基盤となるモデル提供インフラへの制御が少ない |
| マネージドモデルプラットフォーム | モデル選択やデプロイ制御を必要とするチーム | プラットフォーム制約やサービス料金が発生する |
| セルフホスティング型クラウドインフラ | モデル、提供環境、設定を細かく制御したいワークロード | 運用責任が大きくなる |
| オンプレミスインフラ | 特定のデータ所在地、管理要件、専用ハードウェアが必要な場合 | 初期投資と保守コストが必要 |
| ハイブリッドインフラ(Hybrid infrastructure) | 異なるプライバシー、性能、コスト要件を持つワークロード | アーキテクチャとガバナンスが複雑になる |
ホスト型APIは、 多くの場合、最も簡単な開始方法です。プロバイダーがモデル提供環境を管理するため、アプリケーションチームは統合、データ処理、評価、ユーザー体験の改善に集中できます。
マネージドプラッ トフォームは、中間的な選択肢を提供します。すべてのインフラ層を自分たちで運用する必要なく、デプロイツールやインフラ制御機能を利用できます。
セルフホスティングは 組織にモデルバージョン、提供設定、インフラ環境に対するより大きな制御を与えます。ホスト型サービスでは満たせない明確な要件がある場合に適していますが、その一方で、容量計画、アップデート管理、監視、スケーリング、障害対応などの責任も発生します。
オンプレミスおよびハイブリッド導入は、特定のセキュリティ、 規制対応、低レイテンシ、統合要件に対応できます。ただし、そのメリットは、インフラコストや複数環境を運用するための負担と比較して判断する必要があります。
すべてのケースで最も安価、または最も安全な選択肢は存在しません。API利用料金やハードウェア価格だけでなく、エンジニアリング時間、未使用リソース、サポート、ネットワーク、データ転送、セキュリティ、信頼性を含めた総所有コスト(TCO)で比較する必要があります。
本番環境向けのLLMアプリケーションを計画している場合、 ShadhinLabは、アプリケーション要件を評価 し、ビジネスワークロード、統合ニーズ、運用上の制約に合わせたAI導入アプローチの設計を支援できます。
LLMワークロードに適したインフラストラクチャの選び方
アーキテクチャを決定する前に、以下の意思決定フレームワークを活用してください。
ステップ1:ワークロードを定義する
アプリケーションが何を実行する必要があるのかを明確にします。ホスト型モデルAPIを利用するのか、オープンウェイトモデルを展開するのか、既存モデルをファインチューニングするのか、ゼロからモデルを学習するのか、RAGアプリケーションを運用するのか、または複数顧客向けのAIエージェントを提供するのかを確認します。
これらのユースケースでは、必要なインフラ要件が大きく異なります。例えば、モデルをゼロから学習する場合は、既存モデルをAPI経由で提供する場合とは異なる計算リソースやデータ戦略が必要になります。
ステップ2:モデルとメモリ要件を見積もる
セルフホスティング型の導入では、モデルウェイト、実行時オーバーヘッド、KVキャッシュ、コンテキスト長、同時リクエスト数を考慮します。また、選択したモデルが対応するハードウェアと精度設定(Precision)を確認します。
モデルのパラメータ数だけで容量を判断してはいけません。メモリ上に収まる構成であっても、レイテンシやスループットの目標を満たせない可能性があります。
ステップ3:性能目標を設定する
ベンチマークを実施する前に、測定可能な要件を定義します。
- 最初のトークンが生成されるまでの時間。
- トークン生成速度。
- 1秒あたりの処理可能リクエスト数。
- 通常時およびピーク時の同時利用数。
- 可用性および復旧目標。
バックグラウンドで実行される文書処理ジョブで許容される応答時間は、対話型カスタマーサポートAIアシスタントに求められる応答時間とは大きく異なる場合があります。
ステップ4:ワークロードとコストを見積もる
入力・出力トークン量、トラフィックパターン、リソース使用率、将来的な成長予測を見積もります。セルフホスティング型では、AIアクセラレーターの費用、未使用リソース、ストレージ、ネットワーク、保守費用、エンジニアリング時間を含める必要があります。マネージドサービスでは、利用量に応じた料金、プラットフォーム費用、追加のアプリケーションインフラ費用を考慮します。
コスト見積もりをより現実的にするため、理想的なリクエストではなく、実際の利用状況を代表するワークロードを使用してください。
ステップ5:実現可能な最もシンプルなアーキテクチャを選択する
要件を満たす中で、最も複雑ではない構成から始めます。ホスト型APIでユースケースを検証できる場合、最初からGPUクラスタを構築する必要はありません。
実際のコスト、制御要件、レイテンシ、プライバシー要件、モデル互換性などが必要性を示した場合に、マネージド環境やセルフホスティング型インフラへ移行します。
LLMインフラストラクチャのコストと性能を最適化する方法
最適化の目的は、単にハードウェア使用量やトークン料金を削減することではなく、有用な結果を提供するための経済性を向上させることです。
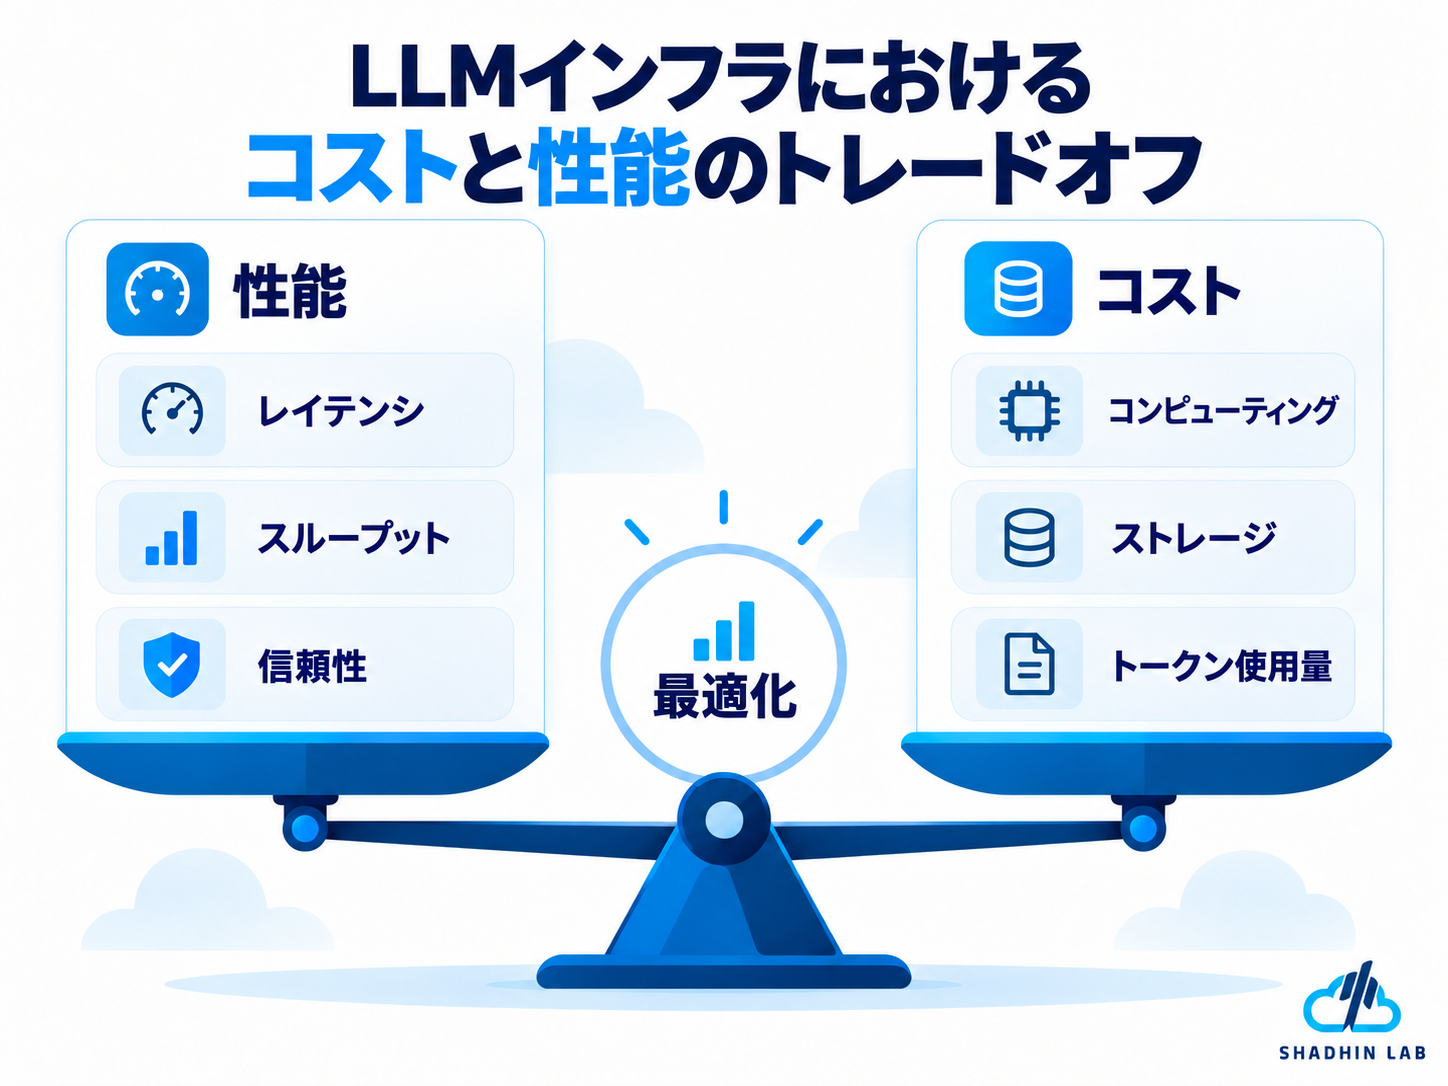
適切なモデルを選択する
分類、構造化データ抽出、要約、その他の限定されたタスクでは、小規模なモデルで十分な場合があります。一方、より複雑なタスクでは、高性能なモデルが必要になる場合があります。
コストだけを基準にモデルを選択する前に、実際の利用ケースを代表する入力データで品質を評価してください。一部のアプリケーションでは、簡単なリクエストを小規模モデルに処理させ、難しいリクエストのみ高性能モデルへ振り分けることで、コストと品質のバランスを取ることができます。
適切な場合に量子化を利用する
量子化(Quantization)は、モデルウェイトやその他の値を低い数値精度で表現する技術です。モデル、ハードウェア、実装方法によっては、必要なメモリ量を削減し、推論効率を向上させることができます。
ただし、低精度化によって出力品質や機能互換性に影響が出る可能性があります。本格導入する前に、アプリケーションの品質要件に対してテストを行い、実際の性能変化を測定する必要があります。
バッチ処理とリクエストスケジューリングを改善する
バッチ処理を利用すると、推論エンジンは複数リクエストの処理をまとめて実行でき、AIアクセラレーターの利用効率を向上させる可能性があります。動的バッチ処理や連続バッチ処理では、リクエストの到着や完了状況に応じて処理スケジュールを調整できます。
ただし、トレードオフとしてレイテンシがあります。大きなバッチを形成するために待機すると、個々のリクエストの応答が遅れる可能性があります。サービスの応答時間目標と実際のトラフィックパターンに合わせてバッチ処理を調整してください。
キャッシュを戦略的に利用する
キャッシュを利用すると、再利用可能な情報を含むリクエストで同じ処理を繰り返すことを防げます。同じプロンプトの一部を再利用する場合は、プロンプトキャッシュやプレフィックスキャッシュが役立ちます。また、検索キャッシュは変更されていない情報に対する繰り返し検索を削減できます。
セマンティックキャッシュは、十分に類似した質問に対して以前の回答を再利用できます。しかし、慎重な管理が必要です。見た目が似た質問でも、権限、日付、ビジネスコンテキストが異なる場合があります。アプリケーションの正確性と情報の最新性要件が許す場合にのみ利用してください。
計算リソースとスケーリングを適正化する
性能目標と可用性目標を満たすために十分な容量を確保しながら、理由なく高価なリソースを未使用状態で維持することは避けます。
オートスケーリングは、需要変化に応じて処理能力を調整できます。ただし、提供プラットフォームが対応しており、ワークロードに対して十分な速度でスケールできることが条件です。モデル読み込み時間、アクセラレーターの利用可能性、急激なトラフィック増加などが、自動スケーリングの効果を制限する場合があります。
ハードウェア容量を増やす前に、リソース使用率やキュー処理状況を測定してください。検索処理、ネットワーク、リクエストスケジューリングのボトルネックは、GPUを追加しても解決できない場合があります。
有用な出力あたりのコストを監視する
トークン料金だけでは、アプリケーションが経済的かどうかを判断できません。コストだけでなく、回答品質、レイテンシ、信頼性、タスク成功率も合わせて追跡する必要があります。
例えば、安価なモデルでも頻繁な再試行や人間による修正が必要な場合、1回で正確な結果を出す高性能モデルよりも、完了したタスクあたりのコストが高くなる可能性があります。適切な評価指標は、アプリケーションのビジネス目的によって異なります。
よくあるLLMインフラストラクチャの失敗例
いくつかのインフラストラクチャ上の判断は、不要なコスト増加や信頼性の問題を引き起こす可能性があります。 -
- 早すぎる過剰設計: 需要を検証する前に分散型モデル提供クラスタを構築すると、価値を確認できないままシステムの複雑性だけが増加します。
- ワークロードを定義する前にハードウェアを選択すること: モデルサイズだけでは、必要なメモリ容量、スループット、レイテンシ要件を決定できません。
- 学習と推論を同じ問題として扱うこと: 両者は計算パターン、必要なリソース、最適化目標が異なります。
- 運用負荷を無視すること: セルフホスティングでは、保守、セキュリティ更新、監視、容量計画、障害対応が必要になります。
- 評価と可観測性を省略すること: サービスが正常なHTTPレスポンスを返していても、不正確または役に立たない回答を生成している可能性があります。
- ボトルネックを分析せずにスケールすること: 計算リソースを増やしても、検索処理の遅延、スケジューリング問題、ストレージ遅延は解決できない場合があります。
- データ準備を過小評価すること: 文書品質、チャンク分割、アクセス権限、更新ワークフローはRAGアプリケーションの性能に影響します。
- 保護されていないモデルエンドポイントを公開すること: 公開・社内向けを問わず、適切な認証、レート制限、アクセス制御が必要です。
- 直接費用だけで比較すること: ホスト型API料金とハードウェア費用は、エンジニアリングコスト、未使用リソース、保守費用を含めなければ単純比較できません。
本番LLMインフラストラクチャを構築するための実践的ロードマップ
段階的な導入方法は、リスクを低減し、実際のデータに基づいてインフラ判断を行うことを可能にします。
ステージ1:プロトタイプ開発 ホスト型APIまたは適切なマネージドプラットフォームを利用して、ユースケースを検証します。専用インフラへ投資する前に、初期段階の品質、レイテンシ、セキュリティ要件を明確にします。
ステージ2:検証 許可された範囲で、実際のビジネスデータや代表的なリクエストを使用してテストします。トラフィック量、コンテキスト長、トークン使用量、プライバシー要件、運用コストを見積もり、ユーザーにとって重要な問題を特定します。
ステージ3:本番基盤の構築 認証、アクセス制御、監視、評価、データ管理、タイムアウト処理、障害復旧機能を実装します。必要に応じて検索機能や業務システムとの統合を追加します。
ステージ4:最適化 モデルや提供設定を比較します。量子化、バッチ処理、キャッシュ、計算リソース配分、リクエストルーティングを評価し、品質や信頼性を大きく損なわず、測定可能な改善を示す変更を採用します。
ステージ5:計画的なスケール拡張 ワークロード測定結果やサービス要件が必要性を示した場合に、オーケストレーション、冗長化、高度なルーティング、分散推論などを導入します。
この方法により、製品要件を理解する前に過剰なインフラ投資を行うことを避けられます。また、次のレベルの複雑性を導入すべきタイミングを判断するための再現可能な方法を作ることができます。
よくある質問
LLM学習インフラと推論インフラの違いは何ですか?
学習インフラは、モデルパラメータを学習・調整するために必要な計算処理とデータ処理を支えます。推論インフラは、既存モデルを利用してリクエストを処理し、回答を生成します。
企業はどのようにLLMインフラコストを削減できますか?
企業は、小規模モデルの評価、適切な量子化、バッチ処理改善、キャッシュ利用、計算リソースの適正化、需要に応じたスケーリングによってコストを削減できます。
RAGアプリケーションにはどのようなインフラが必要ですか?
RAGアプリケーションには通常、文書取り込み、チャンク分割、Embedding生成、ベクトルデータベースまたは検索インデックス、メタデータフィルター、アクセス制御、検索した情報を利用して回答を生成するLLMが必要です。
企業はいつAPI利用ではなくLLMをセルフホスティングすべきですか?
セルフホスティングは、企業が特定のモデル制御、柔軟なデプロイ、またはホスト型サービスでは満たせないインフラ要件を必要とする場合に適しています。
結論
LLM向けAIインフラストラクチャは、単一のハードウェア購入ではありません。計算リソース、ストレージ、ネットワーク、モデル提供、データ検索、セキュリティ、監視を組み合わせた統合システムです。
最適なアーキテクチャは、ワークロード、データの機密性、エンジニアリング能力、トラフィック量、性能目標によって決まります。まずアプリケーションを検証し、実際の動作を測定した上で、必要な場合のみ複雑性を追加してください。
本番環境向けのLLMアプリケーションを開発する組織にとって、ShadhinLabはアプリケーション要件の評価を通じて、 ShadhinLabは、アプリケーション要件を評価 AI開発および導入支援を検討するための入り口を提供します。まずはアプリケーションの要件と統合上の課題を明確にし、その後、最も複雑な技術スタックではなく、自社のビジネスに適したアーキテクチャを選択してください。

Shaif Azad
Shaif Azad Rahi is an AI/ML professional and Solution Engineer at Shadhin Lab, specializing in AI-powered solutions and scalable software systems, with a focus on applying AI to solve real-world business challenges.
Related Post
プロンプトエンジニアリングガイド:より良いAIプロンプトの書き方
You ask an AI model a simple question and get a generic answer. You rewrite the...
2026年版:おすすめAI営業エージェント10選|あなたに最適なのはどれ?
AI sales agents are no longer one clearly defined product category. Some automate outbound prospecting, while...
AI自動化ユースケース完全ガイド:ビジネス運用を今すぐ変革する
Are you overwhelmed by repetitive tasks that consume hours of your valuable time each day? Businesses...
