
AIトークンの基礎知識:仕組みと重要性を解説
Table of Contents
AIチャットボットに質問したり、文書を要約したり、AIを活用したアプリケーションを構築したりする際に、トークン数の上限、利用枠、予想外のAPIコストに直面することがあります。AIトークンの仕組みを理解すると、こうした問題が発生する理由が分かります。
AIモデルは、すべての単語を1つの単位として扱うのではなく、トークンを使って情報を処理します。トークンは、モデルのトークナイザーによって、単語全体、単語の一部、句読点、その他のテキスト要素を表すことがあります。
トークンは、AIモデルが情報を処理する方法、一度に扱える情報量を決めるコンテキストウィンドウ、そして利用量の測定や課金方法に影響します。このガイドでは、AIトークンの仕組み、トークン消費量に影響する要因、そして精度やパフォーマンスを損なうことなく、企業がAIアプリケーションを最適化する方法について解説します。
Table of Contents
主なポイント
- AI言語モデルは、単語、単語の一部、句読点などを表すトークン単位でテキストを処理します。
- トークン数は、トークナイザー、言語、入力形式によって異なります。
- AIのコンテキストウィンドウは、特定のコンテキスト内でモデルが処理できるトークン化された情報量を決定します。
- 多くのAI APIでは、入力トークンと出力トークンに対して個別に料金が発生しますが、料金体系はサービスによって異なります。
- AIエージェントは、複数回のモデル呼び出しや追加情報の処理を行うことで、より多くのトークンを消費する場合があります。
- 効率的なAIアプリケーションは、精度、信頼性、タスクの実行性能を維持しながら、不要なトークン消費を削減します。
AIトークンとは?
AIトークンとは、人工知能モデルがコンテンツを読み取ったり生成したりする際に処理する情報の単位です。大規模言語モデル(LLM)では、トークン化(Tokenization)と呼ばれる処理によってトークンが生成されます。この処理では、テキストをモデルが処理できる小さな単位に変換します。
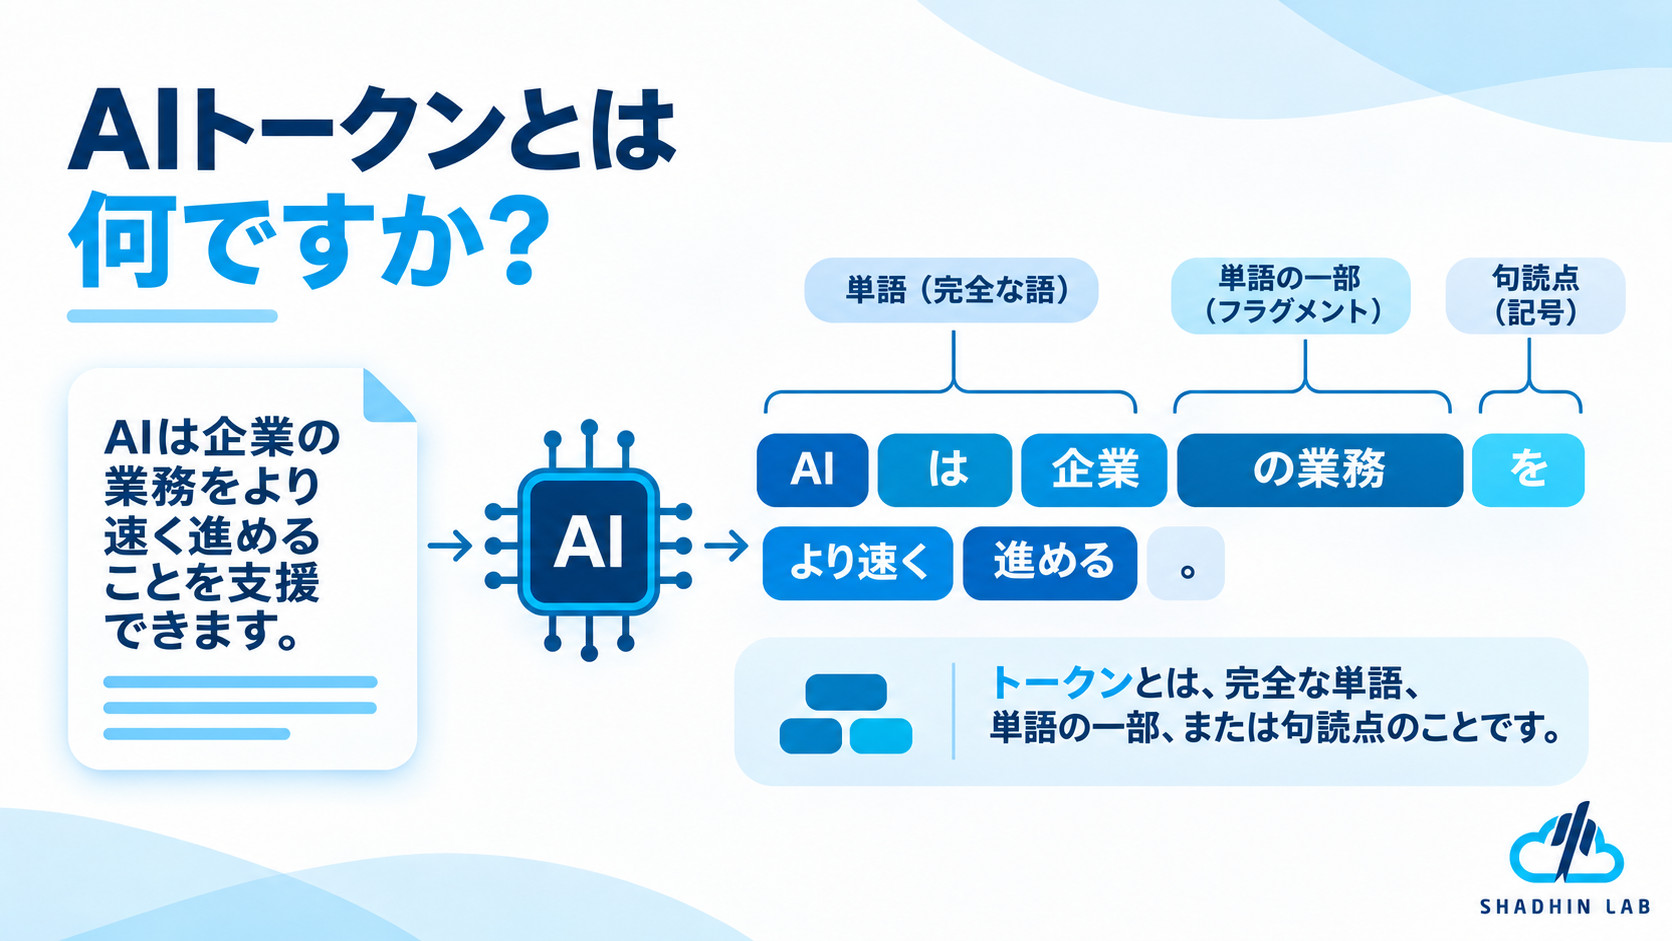
トークンは、次のような要素を表すことがあります。
- のような単語全体 cat
- 接頭辞や接尾辞などの単語の一部
- コンマやピリオドなどの句読点
- トークナイザーによって異なるその他のテキスト要素
次の文章を例に考えてみましょう。
AIは、企業の業務効率を向上させるのに役立ちます。
トークナイザーは、この文章を複数のトークンに分割します。一般的な単語はそれぞれ個別のトークンになる場合がありますが、その他のテキスト要素は異なる形で分割されることもあります。正確な分割位置は、モデルが使用するトークナイザーによって異なります。
トークン化された後、テキストはトークンIDの連続したデータとして表現され、モデルはこれを使って情報を処理します。
AIトークンは単語と同じものですか?
いいえ。単語とトークンは異なる測定単位です。
一般的な単語は1つのトークンで表されることがありますが、長い単語や使用頻度の低い単語は、複数のトークンに分割される場合があります。句読点、スペース、書式、その他のテキストパターンもトークン化に影響します。
以下の例は、仕組みを説明するためのものであり、正確なトークン数を保証するものではありません。
| テキスト | 理解しておくべきこと |
| cat | 一般的な単語は1つのトークンで表される場合があります。 |
| unbelievable | 長い単語は1つまたは複数のトークンで表される場合があります。 |
| AI-powered | ハイフンでつながれた表現は、複数のトークンに分割される場合があります。 |
| Hello! | 単語と句読点は、別々のトークンまたは1つのトークンとして表される場合があります。 |
モデルによって、同じ文章でもトークン化の方法は異なります。そのため、単語数だけでは正確なトークン数を算出できません。
AIモデルがトークンを使用する理由
トークン化によって、言語モデルは一般的な単語、珍しい単語、単語の一部、さまざまなテキストパターンを処理できるようになります。考えられるすべての単語に対して、個別の語彙エントリーを用意する必要はありません。
すべての単語を分割できない単位として扱う代わりに、トークナイザーは再利用可能な部分を使ってテキストを表現できます。この方法により、モデルは未知の用語、専門用語、文章表現の違いにも対応しやすくなります。
開発者や企業にとって、トークン化の仕組みを理解することは、APIの利用量を見積もり、コンテキストの上限を管理し、AIを活用したアプリケーションを設計するうえで役立ちます。
AIトークンの仕組み
AIによるトークン処理は、ユーザーの入力を生成された回答へと変換する一連のステップに沿って行われます。
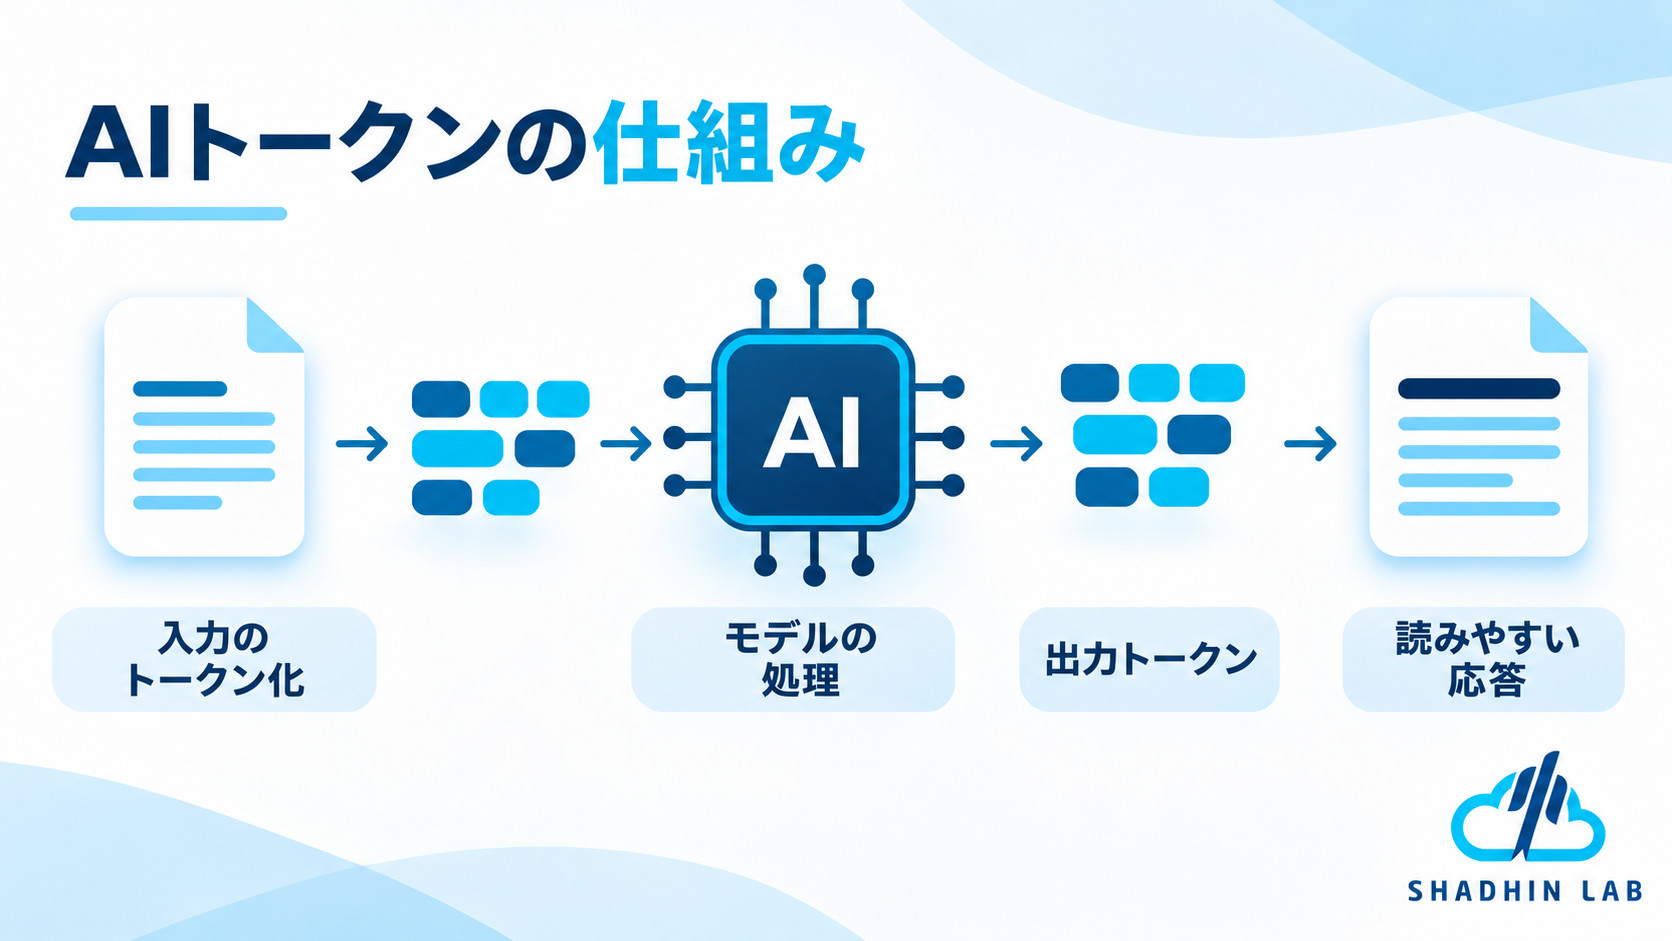
ステップ1:入力テキストのトークン化
プロンプトを送信すると、トークナイザーがテキストを複数のトークンに分割し、それぞれのトークンをトークンIDと呼ばれる数値識別子に対応付けます。
たとえば、AIアシスタントにレポートの要約を依頼するプロンプトは、モデルが処理する前に、一連のトークンIDへと変換されます。
ステップ2:モデルがトークンの並びを処理する
モデルは、学習中に習得したパターンや関係性を利用して、入力の数値表現を処理します。
与えられたコンテキストを考慮し、どのような回答が適切かを判断します。この処理は、個々のトークンを検索したり、あらかじめ用意された回答を取得したりするだけのものではありません。
モデルのアーキテクチャ、学習内容、指示、利用可能なコンテキストのすべてが、生成される回答に影響します。
ステップ3:モデルが出力トークンを生成する
モデルは、出力トークンの連続したデータとして回答を生成します。その後、これらのトークンは人間が読めるテキストに変換されます。
たとえば、ビジネスレポートの短い要約を依頼すると、モデルは入力を処理し、要約を構成するトークンを生成します。
基本的な処理の流れは次のとおりです。
ユーザープロンプト → トークン化 → モデルによる処理 → 出力トークン → 読み取り可能な回答
トークン化は、全体の処理における1つの工程にすぎません。モデルは、利用可能なコンテキストを解釈し、ユーザーの依頼に適切に対応する回答を生成する必要もあります。
1つの単語は何トークンで構成される?
単語数とトークン数の間に、すべてのケースに当てはまる統一的な換算方法はありません。大まかな見積もりとして、英語のテキストは通常、1単語あたり約1.3~1.5トークンになることが多いですが、実際の比率は文章やトークナイザーによって異なります。
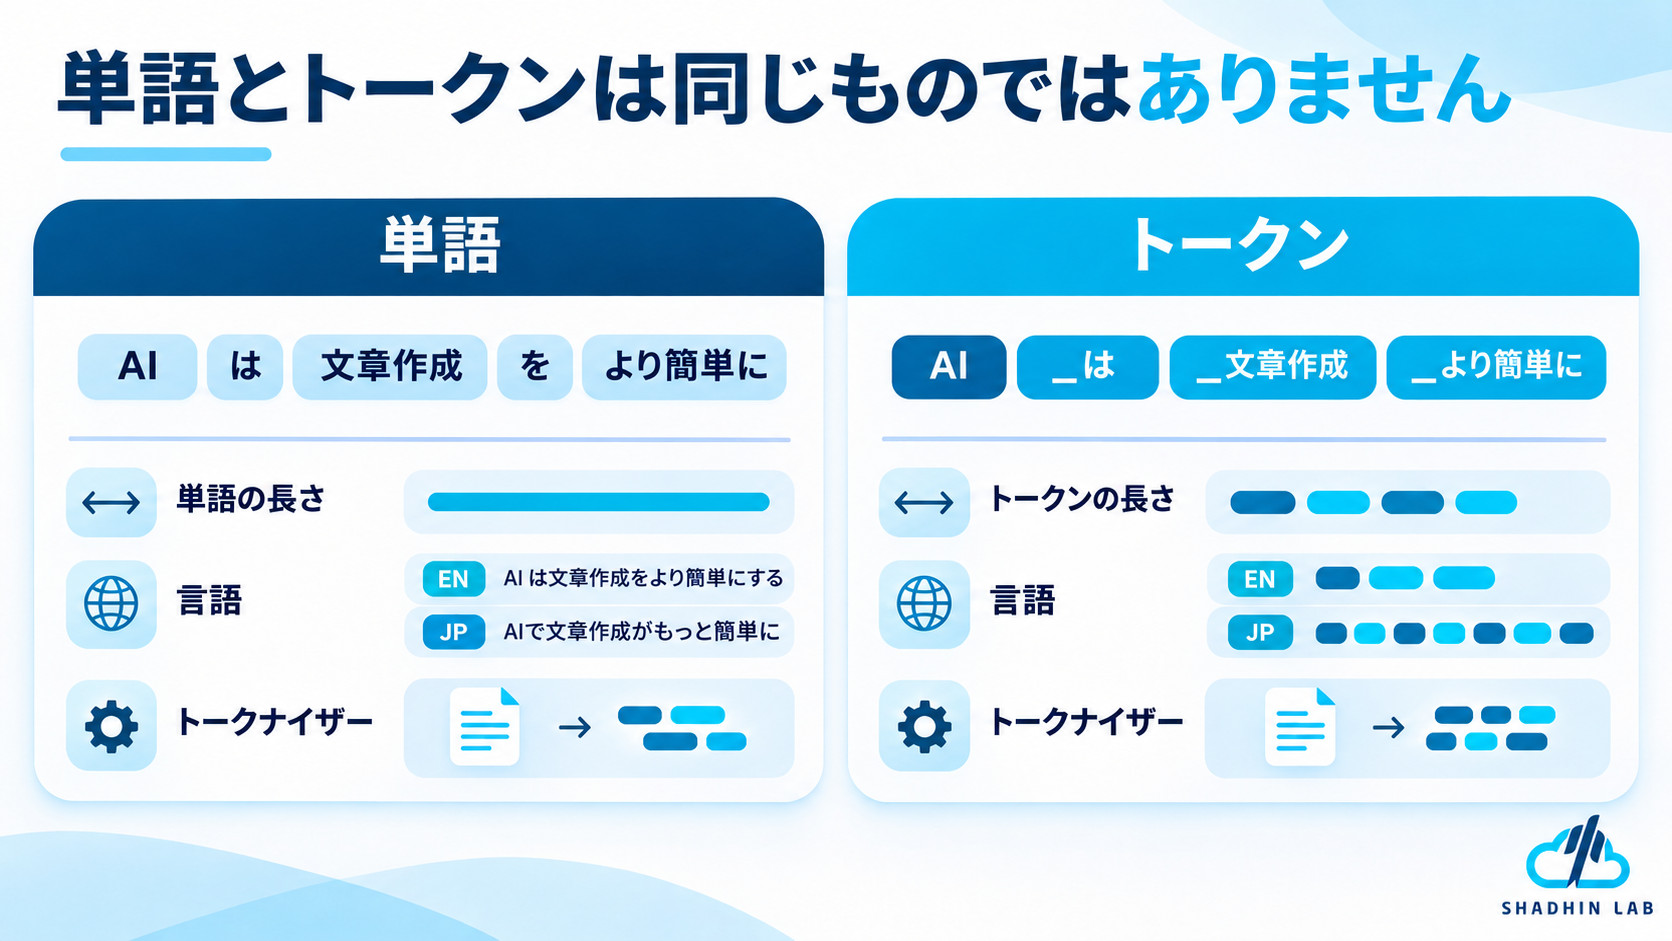
この目安を使うと、英語1,000単語は約1,300~1,500トークンに相当する可能性があります。
これは大まかな計画を立てる際には役立ちますが、正確な計算値として扱うべきではありません。実際のトークン数は、コンテンツによって大きく異なる場合があります。
トークン数に影響する要因
テキストがトークンに変換される際には、いくつかの要因が影響します。
- 単語の長さと使用頻度: 一般的な単語は効率よくトークン化される場合がありますが、珍しい用語や専門用語は複数のトークンに分割されることがあります。
- 句読点と書式: 記号、句読点、書式のパターンは、トークンの分割位置に影響する場合があります。
- プログラミングコードと構造化データ: コード、JSON、その他の構造化形式は、通常の文章とは異なる方法でトークン化される場合があります。
- 言語と文字体系: 言語によってトークン化のパターンや、単語数に対するトークン数の比率が異なる場合があります。
- トークナイザーの設計: トークナイザーごとに、独自の語彙とテキストを分割するルールがあります。
言語によってトークン数は異なりますか?
はい。英語、ベンガル語、日本語など、言語によってトークンの効率は異なる場合があります。
たとえば、英語の単語数とトークン数の目安を、ベンガル語の文書にそのまま適用することはできません。語彙、文字体系、トークナイザーの対応範囲の違いによって、最終的なトークン数が変わる可能性があります。
アプリケーションで正確な利用量が重要な場合は、可能な限り対象モデルに対応したトークナイザーを使用してください。実際のAPI課金額については、プロバイダーの利用状況レポートを確認してください。
入力トークン・出力トークン・推論トークンの違い
AIの利用状況レポートでは、トークンが複数のカテゴリーに分類されている場合があります。これらのカテゴリーを理解することで、開発者はコストを見積もり、どの処理でトークンが消費されているかを把握しやすくなります。
| トークンの種類 | 意味 | 具体例 |
| 入力トークン(Input Tokens) | モデルに提供される情報 | プロンプト、指示、会話履歴 |
| 出力トークン(Output Tokens) | モデルが生成するトークン | 回答、要約、生成コンテンツ |
| 推論トークン(Reasoning Tokens) | このカテゴリーを公開しているモデルにおいて、内部推論に関連するトークン | モデル固有の推論処理における使用量 |
| キャッシュ入力トークン(Cached Input Tokens) | キャッシュ処理の対象となる、以前に処理された入力 | 再利用可能なプロンプトの先頭部分 |
すべてのモデルやプロバイダーが、これらのカテゴリーを個別に報告するわけではありません。また、推論トークンの計上方法やキャッシュ入力の料金設定も、プロバイダーの実装によって異なります。
トークンの使用量はどのように合計されるのか?
入力に800トークンを使用し、300トークンの出力を生成する仮想的なAPIリクエストを考えてみましょう。
入力トークンと出力トークンを合計すると、次のようになります。
800 + 300 = 1,100 tokens
この計算には、追加のトークンカテゴリーやプロバイダー固有の課金ルールは含まれていません。a
トークンの合計数だけでAPIの利用料金が決まるわけではありません。選択したモデル、各トークンカテゴリーの料金、プロバイダーの料金体系など、複数の要素が最終的な費用に影響します。
AIのコンテキストウィンドウとは?
AIのコンテキストウィンドウとは、特定のコンテキスト内でモデルが処理できるトークン化された情報量のことです。
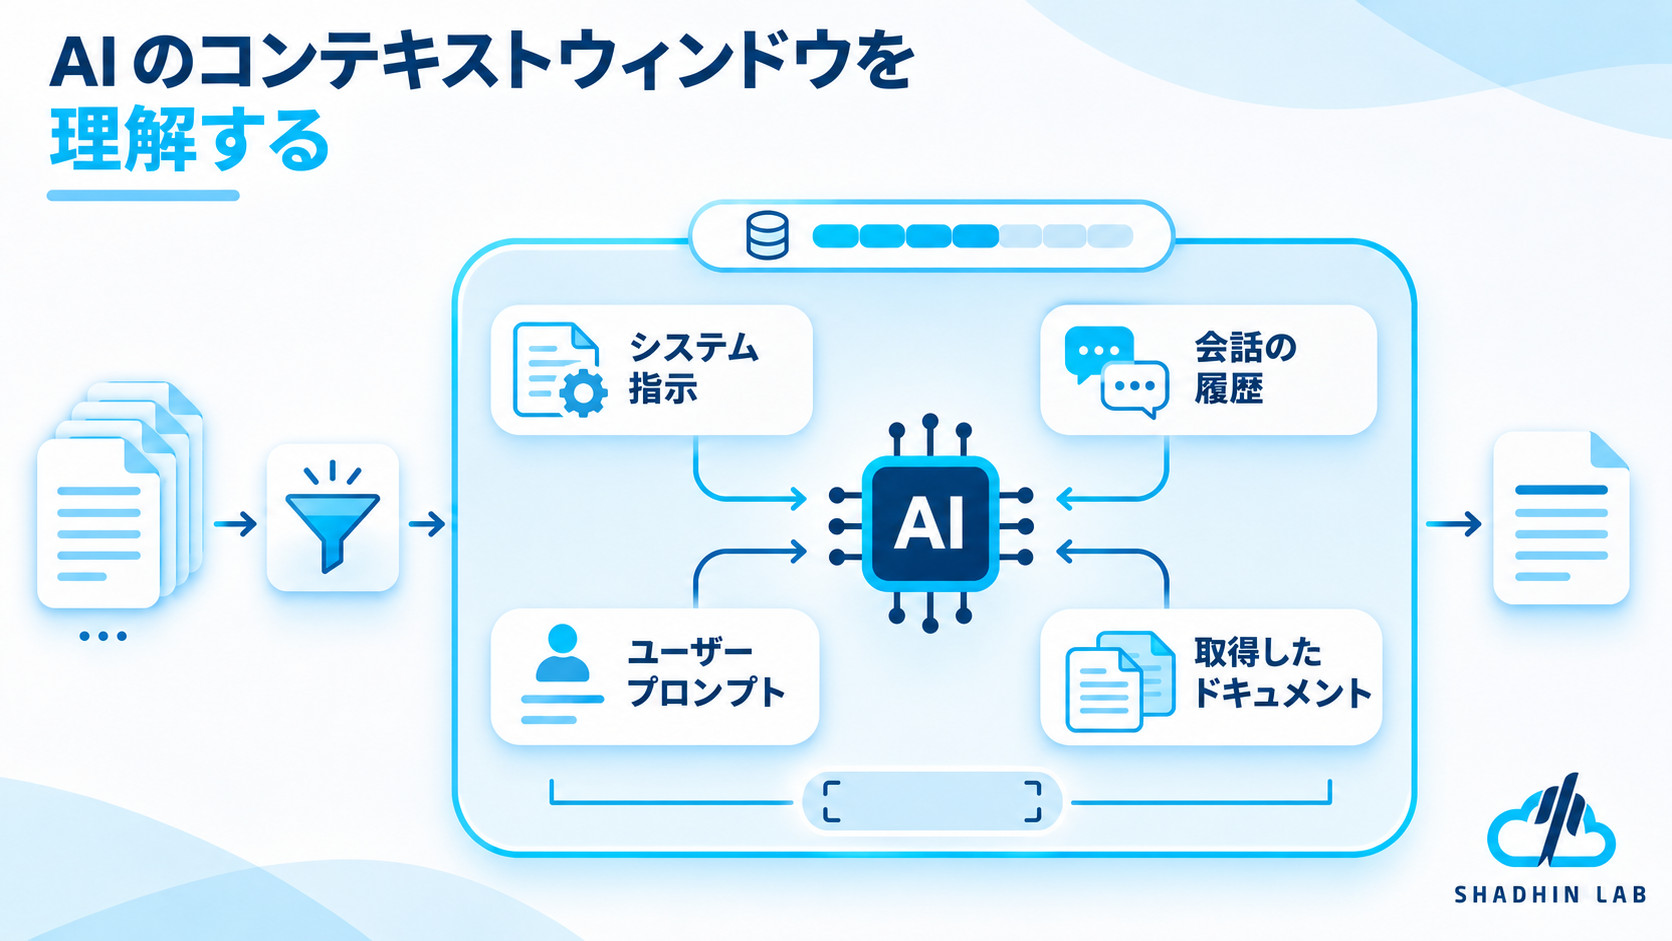
これは、モデルがリクエストを処理する際に利用できる作業用情報の範囲と考えると分かりやすいでしょう。アプリケーションやモデルによって異なりますが、コンテキストには次のような情報が含まれる場合があります。
- アシスタントの動作を定義するシステム指示
- 過去の会話メッセージ
- 現在のユーザープロンプト
- 検索・取得されたドキュメントやその他の提供情報
- アプリケーションで使用されるツールの実行結果やその他の入力情報
モデルの制限によっては、生成される出力も利用可能なコンテキストの容量に含まれる場合があります。
AIがコンテキストの上限に達するとどうなるのか?
利用可能なコンテキストが大きくなりすぎると、アプリケーション側でモデルに送信する情報を管理する必要が生じる場合があります。
そのための方法として、会話履歴の短縮、過去のメッセージの要約、関連する文章の検索・取得、不要になった情報の削除などが挙げられます。
コンテキストの上限に達したからといって、情報が必ずしも永久に失われるわけではありません。現在のリクエストで使用されるアクティブなコンテキストに、一部の情報が含まれなくなる可能性があるということです。
コンテキストウィンドウが大きければ、必ず回答の質も向上するのか?
いいえ。コンテキストウィンドウが大きいと、モデルは長いドキュメント、大量の会話履歴、複雑な情報を処理しやすくなります。しかし、それだけで回答の質が必ず向上するわけではありません。
提供される情報の関連性、モデルの性能、コンテキスト管理の品質も重要な要素です。
例えば、企業がAIを使用して長い社内規定集を分析するケースを考えてみましょう。質問するたびに規定集全体を送信すると、不要なトークン消費が増える可能性があります。代わりに、関連するセクションだけを検索・取得すれば、正確な回答に必要な情報を提供しながら、処理をより効率化できます。
AIのトークン料金はどのように決まるのか?
AIのトークン料金は、利用するサービスや料金体系によって異なります。多くのAI APIでは、入力トークンと出力トークンに対して個別に料金が設定されています。また、キャッシュ入力やその他の利用カテゴリーに異なる料金を適用するサービスもあります。
一方、一般消費者向けのAI製品では、サブスクリプション、クレジット、利用回数や使用量の上限などが採用される場合があります。そのため、すべてのAIとのやり取りにおいて、ユーザーにトークン単位の直接的な料金が表示されるわけではありません。
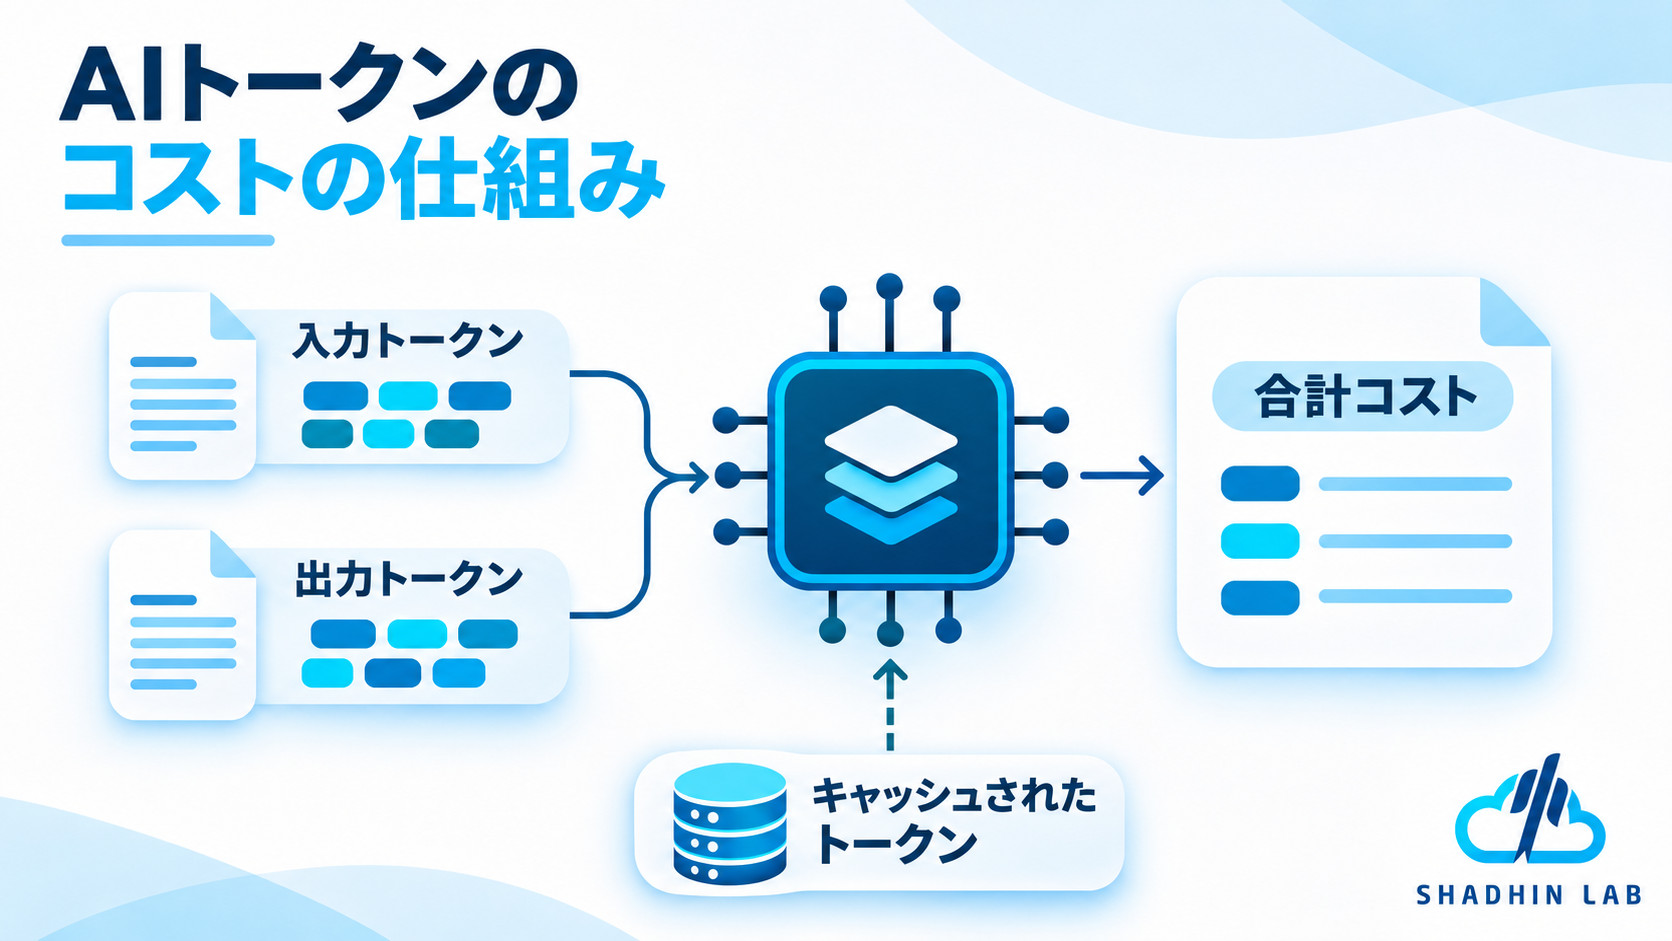
AIトークン料金の簡単な計算例
仮想のAI APIが、次の料金を設定しているとします。
- 入力トークン100万個あたり2ドル
- 出力トークン100万個あたり8ドル
あるアプリケーションが、入力トークン10,000個を含むリクエストを処理し、出力トークン2,000個を生成したとします。
| 計算項目 | コスト |
| 入力:10,000 ÷ 1,000,000 × 2ドル | $0.020 |
| 出力:2,000 ÷ 1,000,000 × 8ドル | $0.016 |
| 合計 | $0.036 |
この仮想的なリクエストの合計料金は 0.036ドル です。
これらの料金は計算方法を説明するための架空の数値であり、特定のAIモデルやプロバイダーの現在の料金を示すものではありません。
企業にとってトークン料金が重要なのはなぜか?
1回のリクエストあたりの料金がわずかでも、アプリケーションが数千回、数百万回のリクエストを処理すると、コストは積み重なっていきます。
例えば、カスタマーサポート用のAIアシスタントは1日を通して問い合わせに対応する場合があります。一方、AIを活用したレポート作成システムは、大量のドキュメントを処理し、1つのレポートを完成させるために複数回のモデル呼び出しを行うことがあります。
総費用は、トークン消費量、モデルの料金設定、出力の長さ、各タスクの完了に必要なモデルとのやり取りの回数によって決まります。
AIのトークン料金を理解することは、企業が運用コストを見積もり、モデルの選択肢を比較し、AIアプリケーションの設計について適切な判断を下すうえで役立ちます。
AIのトークンコストが予想以上に増加する理由
トークン単価が安くても、必ずしも運用コストが低くなるとは限りません。アプリケーションが過剰なトークンを消費したり、より高額なモデルを使用したり、不要な処理を繰り返したりすることで、企業の支出が予想以上に増加する可能性があります。
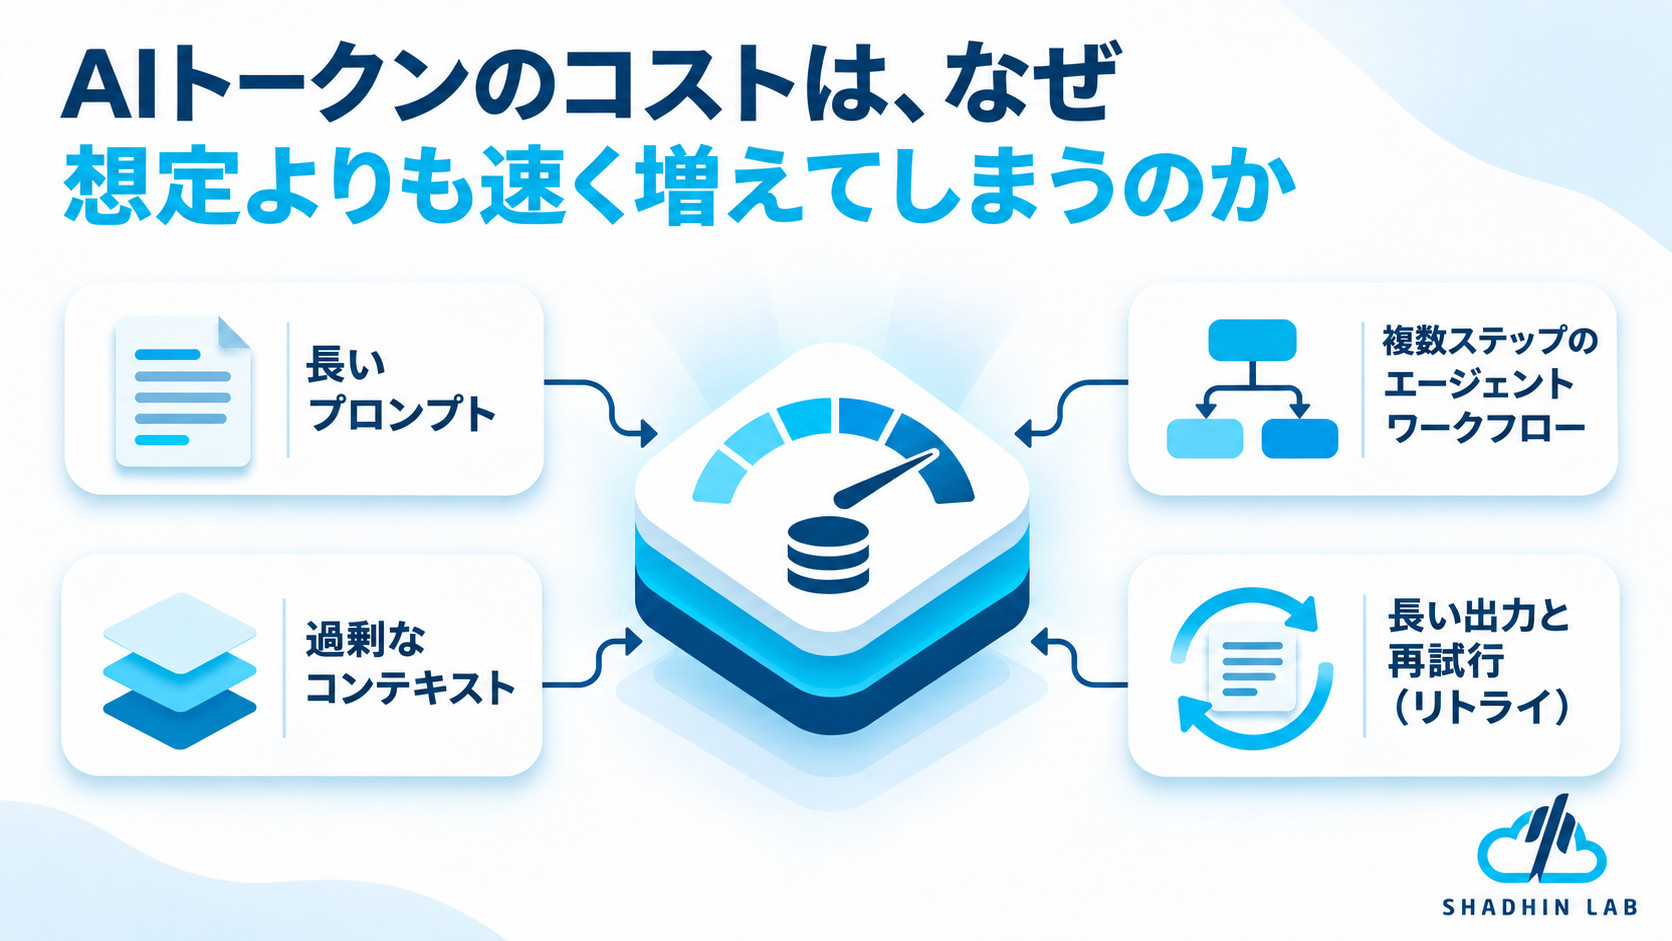
長いプロンプトとコンテキストの繰り返し
システム指示、会話履歴、背景情報などは、入力トークンの消費量を増加させる可能性があります。
アプリケーションが同じ長い指示を繰り返し送信したり、リクエスト間で情報を重複させたりすると、必要以上に多くのトークンを使用することがあります。対応している環境ではキャッシュが役立つ場合もありますが、その利用可否や課金上のメリットはプロバイダーによって異なります。
解決策は、重要な指示と関連するコンテキストを維持しながら、不要な繰り返しを取り除くことです。
過剰なコンテキストと不要な情報検索
AIアプリケーションは、回答を生成する前に、ドキュメント、データベース、ナレッジベースなどから情報を検索・取得することがよくあります。
ドキュメント全体や大量の検索結果をモデルに送信すると、回答の質が比例して向上しないまま、トークン消費量だけが増加する可能性があります。
関連する文章だけを選択することで、モデルはタスクに必要な情報に集中できます。検索精度を高めることで、無関係なコンテキストを減らしながら、処理効率を改善できます。
複数ステップで実行されるAIエージェントのワークフロー
AIエージェントは、情報の検索、外部ツールの呼び出し、結果の評価、最終回答の生成などを、複数回のモデルとのやり取りを通じて実行する場合があります。
追加の呼び出しが発生するたびに、モデルやワークフローに応じて、入力トークン、出力トークン、推論トークンの消費量が増える可能性があります。
例えば、単純な質問に回答するチャットボットと、CRMデータ、計算処理、複数の確認作業を使用して営業レポートを作成するAIエージェントを比較してみましょう。営業レポートを作成するエージェントは、複数の異なる処理を実行するため、より多くの処理を必要とする場合があります。
ただし、AIエージェントのトークン消費量に共通の倍率はありません。実際の使用量は、タスク、コンテキスト、モデル、ワークフローの設計によって異なります。
長い出力、再試行、繰り返されるリクエスト
長い回答は、必要以上に多くの出力トークンを消費する可能性があります。また、処理の失敗、APIの再呼び出し、適切に設計されていないワークフローも、トークン消費量を増加させる原因になります。
例えば、最初の出力形式が明確でなかったために、アプリケーションがレポートの再生成をモデルに繰り返し要求すると、得られる価値に見合わない追加のトークンを消費する可能性があります。
明確な指示、適切な出力制限、効果的なエラー処理を導入することで、こうした無駄を防ぐことができます。
品質を損なわずにAIのトークン消費量を削減する方法
AIのトークン最適化は、単にトークンの使用量を減らすことではありません。精度、信頼性、タスクの実行性能を維持しながら、不要な処理を減らし、必要な結果をより効率的に得ることが目的です。
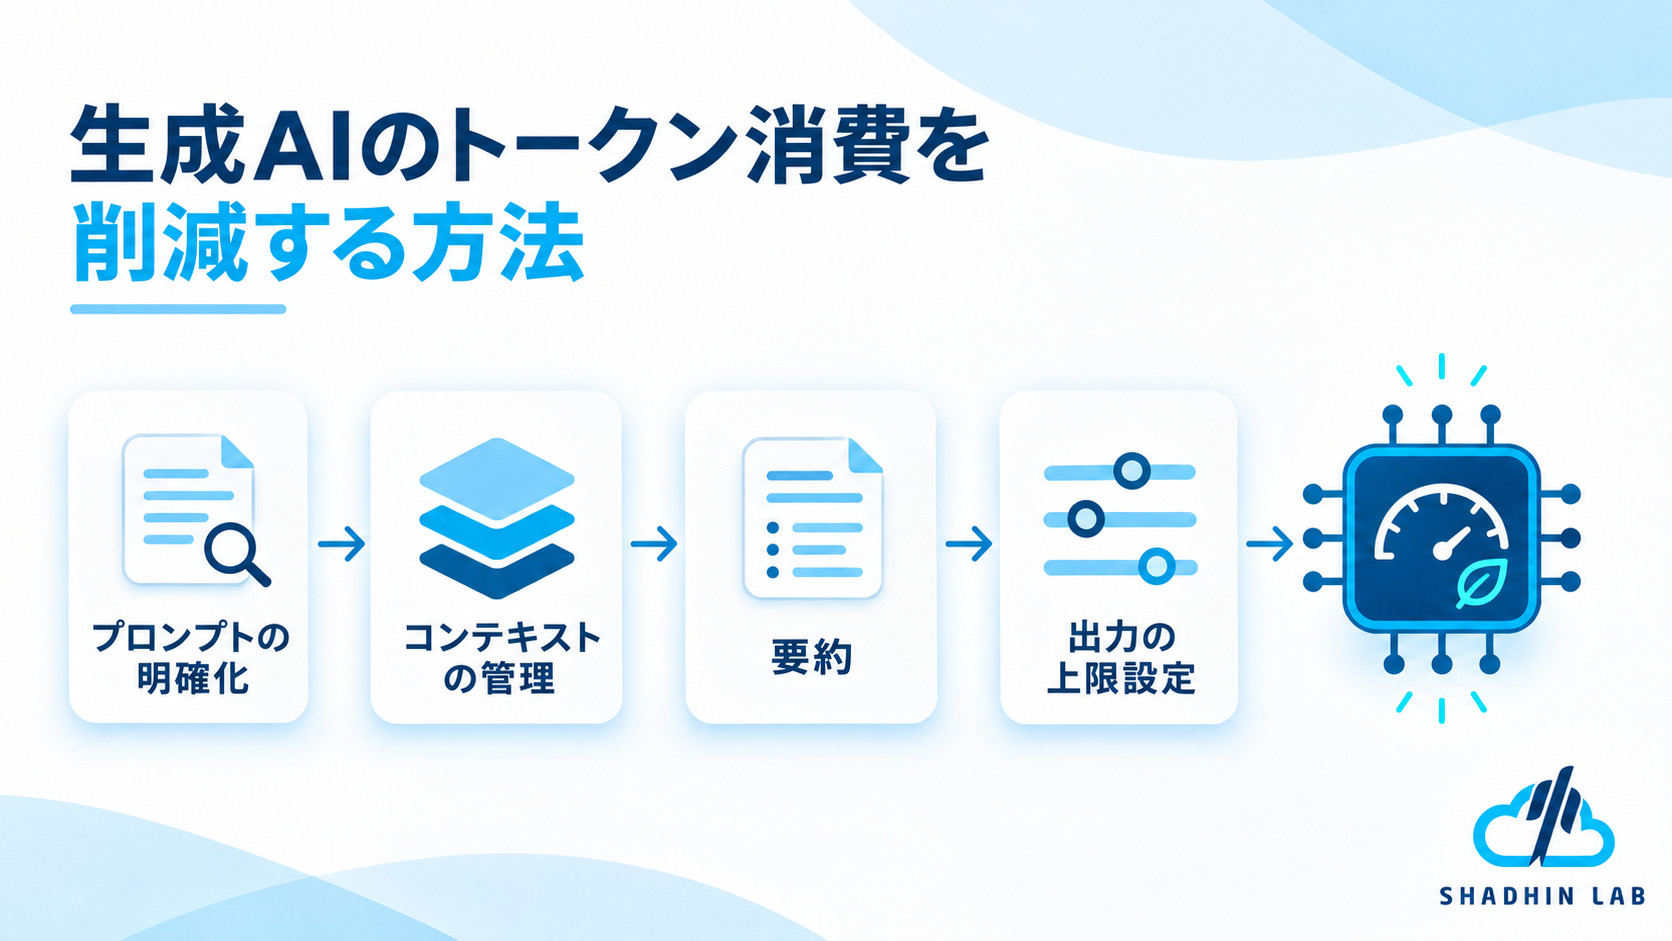
プロンプトを簡潔にし、重複を取り除く
プロンプトを見直し、繰り返される指示、関連性の低い背景情報、不要な例を削除しましょう。
例えば、商品説明を生成するアプリケーションでは、すべてのリクエストに同じ書式ルールを何度も含める必要はない場合があります。
ただし、信頼性の高い回答を生成するためにモデルが必要とする情報まで削除してはいけません。必要なコンテキストを維持できる場合に限り、簡潔さが効果を発揮します。
すべての情報を送信せず、関連情報だけを取得する
ドキュメント検索、フィルタリング、要約、検索拡張生成(RAG)を活用することで、AIアプリケーションは大量のドキュメント全体を繰り返し送信することなく、関連情報を提供できます。
RAGとは、外部のナレッジソースから関連情報を検索・取得し、その情報をコンテキストとしてモデルに提供する手法です。
例えば、社内規定に関する質問に回答するAIアシスタントでは、質問のたびに規定集全体を処理するのではなく、関連する規定のセクションだけを取得できます。
ただし、情報検索の品質も重要です。トークン消費量が減少しても、重要な情報が取得されなければ、回答の精度が低下する可能性があります。
タスクの複雑さに応じてモデルを選択する
タスクによって、必要とされるモデルの性能は異なります。
単純な分類や書式設定のタスクには、複雑な分析タスクと同じレベルの推論能力が必要とは限りません。企業は、最も安価なモデルや最も高性能なモデルを自動的に選ぶのではなく、実際の業務を代表するワークロードを使用してモデルを評価する必要があります。
出力品質、信頼性、応答速度、総コストを比較し、それぞれのタスクに最適なモデルを判断しましょう。
出力の長さと繰り返される呼び出しを管理する
適切な出力上限を設定し、詳細な説明が不要な場合は簡潔な回答を要求しましょう。
AIエージェントについては、それぞれのモデル呼び出し、推論ステップ、ツールとのやり取りが最終的な結果に実質的な価値をもたらしているかを確認してください。
重複する呼び出しを削減し、エラー処理を改善することで、必要なワークフローを維持しながらトークン消費量を抑えられます。
適切な場面でキャッシュを活用する
対応しているキャッシュ機能を利用すると、条件を満たす場合に、繰り返し入力される情報の処理コストを削減できる可能性があります。
例えば、同じ長い指示文の先頭部分を頻繁に使用するアプリケーションでは、プロバイダーが提供するプロンプトキャッシュ機能が役立つ場合があります。
キャッシュの適用ルール、利用条件、実装方法、期待できるコスト削減効果は、プロバイダーによって異なります。最適化手法としてキャッシュに依存する前に、関連する公式ドキュメントを確認してください。
AIを活用したワークフローを構築する企業は、モデルの選択、データアクセス、システム連携、ワークフロー設計、利用状況の監視を総合的に検討する必要があります。自社のビジネスに適した導入方法について相談するには、ShadhinLabが提供する関連AI開発サービスをご覧ください。
実際のアプリケーションでAIのトークン効率を測定する方法
トークン数だけでは、AIアプリケーションの効率性を判断できません。トークン消費量が少なくても、不正確な回答を生成するシステムは、より多くのトークンを使用しても、目的のタスクを確実に完了できるシステムより実用性が低い場合があります。
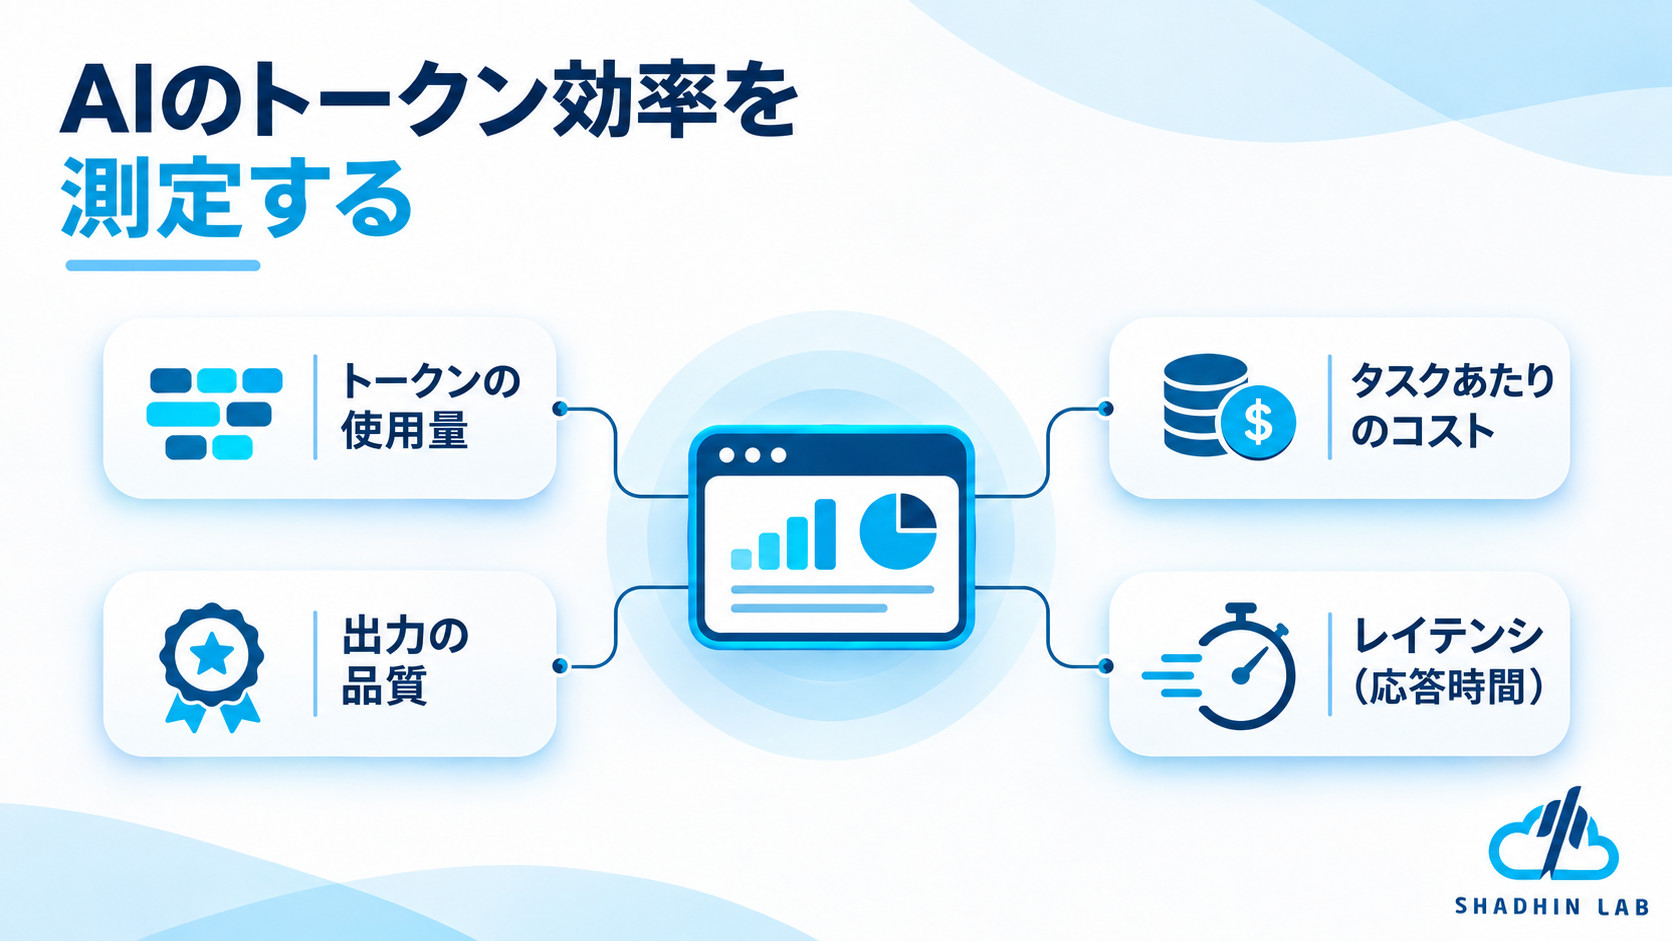
実用的な測定フレームワークでは、トークン消費量、運用コスト、タスクの成果を組み合わせて評価します。
リクエストまたはタスクあたりのトークン数
個々のリクエストや完了したタスクについて、入力トークンと出力トークンを追跡します。これにより、トークン消費量の多い処理を特定し、類似するワークロードを比較できます。
複数のステップを必要とするアプリケーションでは、最終回答だけでなく、タスクの完了に必要なすべてのモデル呼び出しを測定対象に含めます。
タスク成功1件あたりのコスト
1回のAPI呼び出しの料金だけに注目するのではなく、目的の結果を達成するために必要な総コストを測定します。
例えば、2つのカスタマーサポートのワークフローを比較する場合、モデルの呼び出し、再試行、追加処理にかかる費用も含めて評価します。サービス品質が許容できる水準を維持しているなら、問題解決1件あたりのコストが低いワークフローの方が効率的である可能性があります。
タスク成功率と出力品質
アプリケーションがタスクをどの程度正確かつ安定して完了できるかを測定します。
ユースケースに応じて、明確に定義された品質基準、人によるレビュー、適切な自動評価手法などを使用できます。
これにより、トークンの最適化によって品質が低下していないか、またはアプリケーションが本来の業務を遂行する能力に影響が出ていないかを確認できます。
モデル呼び出し回数と応答遅延
モデルの呼び出し回数、再試行回数、タスク完了までに必要な時間を追跡します。
これらの指標から、不要な処理、非効率なツールの使用、パフォーマンス上のボトルネックを特定できます。また、最適化によって応答速度を犠牲にしてコストが削減されていないかを把握するのにも役立ちます。
最適化の前にベースラインを設定する
ワークフローを変更する前に、トークン使用量、コスト、出力品質、タスク完了率を記録します。その後、同等のタスクを使用して改善後のバージョンをテストします。
| 指標 | 測定する内容 | Why it matters |
| タスクあたりのトークン数 | 完了したタスクにおけるトークン消費量 | トークン消費量の多いワークフローを特定する |
| タスク成功1件あたりのコスト | 目的の成果を達成するための費用 | 支出とビジネス価値を関連付ける |
| タスク成功率 | ワークフローが目標を達成する頻度 | 最適化中の信頼性を維持する |
| タスクあたりのモデル呼び出し回数 | 必要となるモデルとのやり取りの回数 | 不要な処理を特定する |
| 応答遅延 | タスクの完了に必要な時間 | 最適化が処理速度に与える影響を把握する |
これらは実務で役立つ運用指標であり、普遍的に標準化された評価システムではありません。アプリケーションの目的、利用可能な使用量データ、ビジネス要件に応じて、適切な指標を選択してください。
AIトークンに関するよくある質問(FAQ)
AIトークンとは何ですか?簡単に説明すると?
AIトークンとは、AIモデルが情報を読み取ったり生成したりする際に処理する情報の単位です。言語モデルでは、トークンは単語全体、単語の一部、句読点、その他のテキスト要素を表す場合があります。トークン化によって、モデルが処理を行う前にテキストがこれらの単位に変換されます。
1,000単語には何個のトークンが含まれますか?
正確な換算方法はありません。英語の場合、1,000単語あたり約1,300~1,500トークンが大まかな目安ですが、実際の数は文章の内容やトークナイザーによって異なります。正確な数を把握する必要がある場合は、対象モデルに対応したトークナイザーを使用してください。
AIトークンには料金がかかりますか?
トークン自体に必ず料金が発生するわけではありません。料金は、利用するAIサービスとその課金体系によって異なります。入力トークンと出力トークンの使用量に応じて課金するAPIもあれば、一般消費者向けの製品ではサブスクリプション、クレジット、利用上限などを採用している場合もあります。
トークンとパラメータの違いは何ですか?
トークンは、モデルが処理する情報の単位です。一方、パラメータは、モデル内部にある学習済みの数値であり、モデルの動作に影響を与えます。トークンは処理対象となる入力や出力を表し、パラメータはモデルそのものを構成する要素です。
AIモデルにはなぜトークン制限があるのですか?
モデルには、特定のコンテキスト内で処理できるトークン化された情報量や、1回の応答で生成できるトークン数に上限があります。これらの制限は、モデルやサービスによって異なります。長い入力を処理する場合、アプリケーションは会話履歴を要約したり、関連情報を検索・取得したりして情報量を管理できます。
AIエージェントはチャットボットより多くのトークンを使用しますか?
その可能性があります。複数のステップを実行したり、情報を検索したり、ツールを呼び出したり、結果を評価したりするAIエージェントは、単純なチャットボットとのやり取りよりも多くのトークンを消費する場合があります。実際の消費量は、モデル、タスクの複雑さ、コンテキスト、ワークフローの設計によって異なります。
AIのトークン使用量を確認するにはどうすればよいですか?
対象モデルに対応したトークナイザーを使用すると、テキストのトークン数を推定または計測できます。APIを利用するアプリケーションでは、利用状況レポートから実際の消費量や、提供されている場合は課金対象となるトークンのカテゴリーを確認できます。モデル固有のツールやレポート機能については、プロバイダーの公式ドキュメントを参照してください。
まとめ
AIトークンは、言語モデルが情報を処理・生成するうえで不可欠な要素です。その仕組みを理解することで、個人や企業はトークン制限を正しく把握し、使用量を見積もり、APIコストを管理し、より効率的なAIアプリケーションを設計できるようになります。
特に重要なのは、次の3つの原則です。トークン数と単語数は同じではないこと、コンテキストの上限や料金体系はモデルやプロバイダーによって異なること、そしてトークン数を減らせば必ずしもパフォーマンスが向上するわけではないことです。
最も効果的なアプローチは、精度、信頼性、タスクの成功率を維持しながら、不要なコンテキストやモデルの呼び出しを削減することです。
AIを活用したアプリケーションやワークフローの導入を検討している企業は、ShadhinLabが提供する関連AI開発サービスをご覧いただき、自社に適した実装方法をご確認ください。

Abrar Rafid
Abrar Rafidは、Shadhin Lab LLCのプロジェクトコーディネーター兼コンテンツライターです。ソフトウェア開発プロジェクトの進行管理、クライアントと社内チーム間のコミュニケーション調整、プロジェクトの進捗管理を担当しています。また、ビジネスコミュニケーション、提案書、デジタルプラットフォーム向けの専門的なコンテンツの作成および校正にも携わっています。
Related Post
ERPとCRM:自社のビジネスに適しているのはどちら?
Imagine a growing business where sales representatives track leads in spreadsheets while the operations team manages...
バイブコーディングのセキュリティリスク:注意すべきポイント
Vibe coding makes it easier to build applications by describing what you want and letting AI...
おすすめのAIエージェント構築ツール7選を徹底比較
AI agent builders make it possible to create AI systems that do more than answer questions....
